IMU Algo
各种函数的增长趋势的排序:c < log2n < n < nlog2n < n2 < n3 < 2n < 3n < n!
当 T(n) 为对数函数 (log2n),幂函数 (n2,n3…) 或它们的乘积 (nlog2n) 时,算法的运行时间是可以接受的,我们称这些算法为有效的算法。 当 T(n) 为指数函数 (2n) 或阶乘函数 (n!) 时,算法的运行时间随 n 而迅速增大,是不可接受的。我们称这些算法是“坏”的算法或无效的算法。
栈与队列
栈
ADT 栈
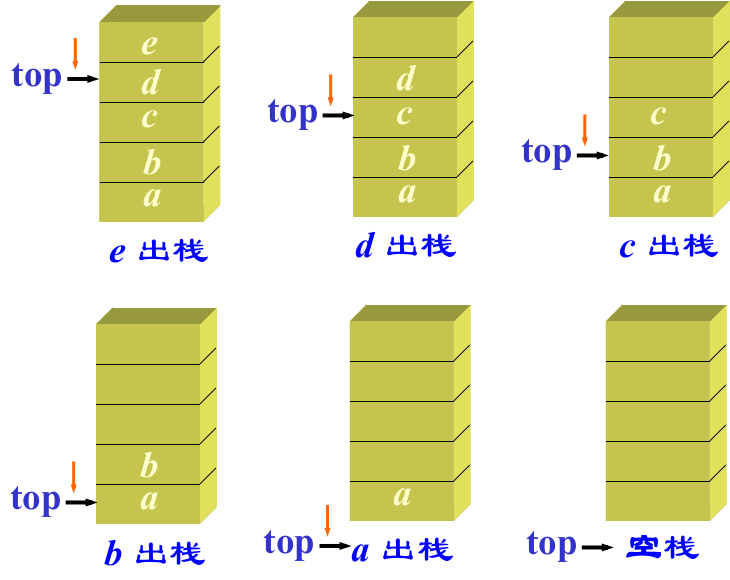
栈是一种操作受限的线性表,它的插入和删除操作只允许在表的同一端进行。
允许插入和删除 的一端称为栈顶 (top),另一端称为栈底 (bottom)。
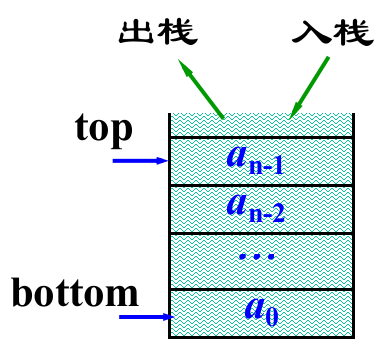
栈结构的特点:先进后出 (First In Last Out, FILO) 或者后进先出 (Last In First Out, LIFO)。
栈结构的特点:先进后出 (First In Last Out, FILO) 或者后进先出 (Last In First Out, LIFO)。
假设栈 S=(a0, a1, …, an-1),a0 是栈底元素,an-1 是栈顶元素。
入栈(插入操作)的顺序为 a0, a1, …, an-1
出栈(删除操作)的顺序为 an-1, an-2, …, a0
ADT Stack {
 Data
	数据元素表
	top: 栈顶位置
 Operations
	 Constructor
		  Process: 创建一个空栈
	 IsEmpty
		  Process: 判断栈是否为空
		  Output: 如果栈为空,则返回true,否则返回false
	 GetTop
		  Process: 取栈顶元素
		  Output: 返回栈顶元素
   Push      // 入栈
		 Input: 要添加的数据元素
		 Process: 向栈中添加元素x
	 Pop       // 出栈
		  Process: 删除栈顶元素
		  Output: 返回栈顶元素
	 Clear
		  Process: 删除栈中所有元素并置新的栈顶
} //Stack
栈的实现
栈结构的实现方式:
- 顺序存储
- 一维数组,栈有大小限制。
- 链式存储
- 链表实现,栈无大小限制。
栈的顺序(数组)存储表示 — 顺序栈
定义顺序栈时,应包括以下内容:
顺序表(数组):StackList
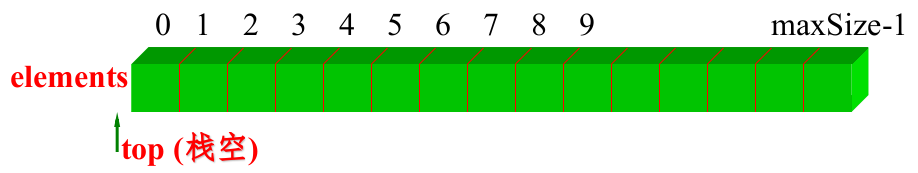
栈顶下标:top
- 当栈为空时,top=-1;
- 每当一个元素入栈,top 的值增 1;
- 每当一个元素出栈,top 的值减 1。
const int MaxStackSize=50; //栈最大容量
class SeqStack {
	DataType StackList[MaxStackSize];
	int top;                 //栈顶指针
 public:
	SeqStack( );                  //构造函数
	bool IsEmpty( );
	bool IsFull( ) ;
	DataType GetTop( );        //取栈顶
	void Push(const DataType x);       //入栈
	DataType Pop( );              //出栈
	void Clear( ) ;                 //置栈空
}; //SeqStack
 SeqStack:SeqStack( ) {  //构造函数,初始化一个空栈
   StackList = new DataType[MaxStackSize];
   top=-1;
	} //SeqStack
   bool SeqStack:IsEmpty( ) {  //判断栈是否为空
  if(top==-1)     return true;
  else      return false;
	} //IsEmpty
bool SeqStack:IsFull( ) //判断栈是否已满
{
 if(top==MaxStackSize-1)
	  return true;
 else
	 return false;
 } //IsFull
DataType SeqStack:GetTop( ) //取栈顶元素
{
 if (IsEmpty( ))
{
	  cout<<"栈空!"<<endl;
	  return nulldata;
 }
 return StackList[top];
} //GetTop
void SeqStack:Push(DataType x) //入栈
{
 if (IsFull( ))
	 cout<<"栈满!"<<endl;
else
	StackList[++top] = x;
} //Push
DataType SeqStack:Pop( )   //出栈
{
	if (IsEmpty( ))
	{
   cout<<"栈空!"<<endl;
   return nulldata;
	}
	return StackList[top--];
} //Pop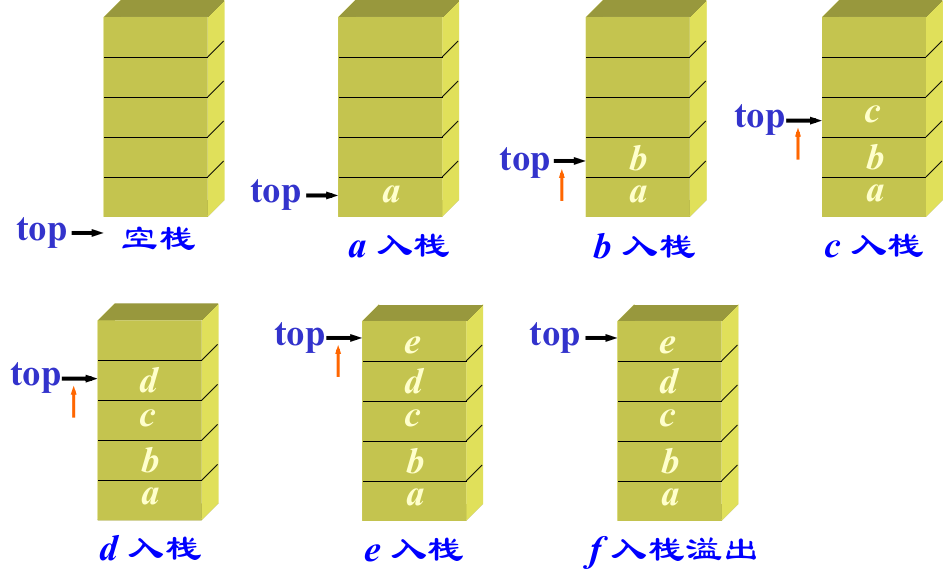
算法分析:
以上有关栈的各种操作与栈中元素个数无关。 时间复杂度均为O(1)。
定义顺序栈时,应该知道所需的最大栈长度。 如果事先无法预知栈的最大长度,可以采用链式栈。
栈的链式存储表示 — 链式栈

链式栈空间可扩充,无栈满 (溢出) 问题;
插入与删除仅在栈顶处执行;
链式栈的栈顶在链表头;
对于带头结点的链式栈,栈空的条件是top→next==NULL。
  class StackNode {
       DataType data;           //结点数据
       StackNode *next;       //结点指针
  public:
      StackNode( DataType d=nulldata )
      {  data=d; next=NULL; }
       friend class LinkStack;
  }; //StackNode
  class LinkStack {
      StackNode *top;            //栈顶指针
  public:
      LinkStack( )
      { top=new StackNode(); top->next=NULL; } //创建头结点
      void Push(DataType data);   //入栈
      DataType Pop( );                   //出栈
  DataType GetTop( );           // 读栈顶元素
  void Clear( ); //清空栈
  bool IsEmpty( ) {return top->next == NULL; } //判栈空
  };  //LinkStack
  void LinkStack: Push(DataType item)
  { //入栈操作
     p=new StackNode (item);
     p->next=top->next; //类似于头插法
     top->next=p;
  } //Push
  DataType LinkStack: Pop( )
  {//出栈操作
    if ( top->next!=NULL ){
         p = top->next;
         retvalue = p->data;          //暂存栈顶数据
         top ->next= p->next;         //修改栈顶指针
         delete p;
         return retvalue;
    }//释放,返回数据
    else{//栈空的情况
        cout<<"The stack is empty!"<<endl;
        return nulldata;
    }
  } //Pop
  DataType LinkStack: GetTop( ) //取栈顶元素操作
  {
    if (top->next!=NULL)
        return top->next->data;
    else //栈空的情况
    {
        cout<<"The stack is empty!"<<endl;
        return nulldata;
    }
  } //GetTop
队列 ( Queue )
一种操作受限的线性表,只允许在一端删除,在另一端插入。 允许删除的一端叫做队头 (front),允许插入的一端叫做队尾 (rear)。
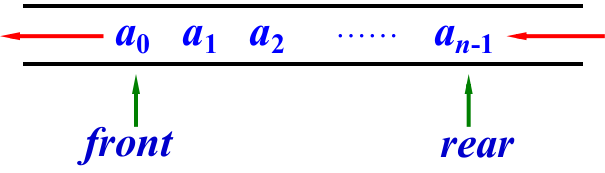
特性 先进先出 (FIFO, First In First Out)
ADT 队列
  ADT Queue {
  Data
       数据项列表
       front: 队列中第一个元素的位置
       rear:  队列中最后一个元素的位置
  Operations
       Constructor
         Process: 初始化队首和队尾
  IsEmpty
   Process: 判断是否为空队列
   Output: 若队列空,返回true,否则返回false
  Front
   Process: 取出队头元素
   Output: 返回队头元素
  ClearQueue
   Process: 删除队列中所有元素并设置初始状态
  IsFull
   Process: 判断队列是否已满
   Output: 若队列已满,返回true,否则返回false
  Enter
    Input: 要进入队列的元素
     Process: 在队尾插入新的元素
  Leave
    Process: 删除队头元素
    Output: 返回队头元素
  } //Queue
队列的实现
队列的实现方式:(类似于线性表、栈)
顺序存储
- 一维数组,队列长度有限制。
链式存储
- 链表实现,队列长度无限制。 在队列的顺序存储表示中:
用一维数组来存放数据元素:
- 一维数组:QueueList[MaxQSize]
设置两个变量分别指向队头和队尾的位置:
- 队头位置:front
- 队尾位置:rear 顺序队列的定义如下:
    const int MaxQSize=50; //队列中数据元素的上限
    class SeqQueue {
        DataType QueueList[MaxQSize]; //数据元素列表
        int front, rear; //指向队头和队尾位置的变量
      public:
        SeqQueue( ); //构造函数,建立空队列
        void Enter(DataType item); //入队列
    DataType Leave( );  //出队列
        void Clear( );  //清空队列
        DataType Front( ); //取出队头元素
        bool IsEmpty( );  //判断队列是否为空
        bool IsFull( );  //判断队列是否已满
    }; //SeqQueue
入队原则 : 入队时,先将新元素放入 rear 指示的位置,再将尾指针增 1. rear = rear + 1。rear 始终指示队尾元素的下一个位置。 出队原则 : 出队时,先将下标为 front 的元素取出,再将头指针增一 front = front + 1。front 始终指示队头元素的位置。 空队列和满队列的条件
空队列的条件:front rear 0;
满队列的条件:rear == MaxQSize;
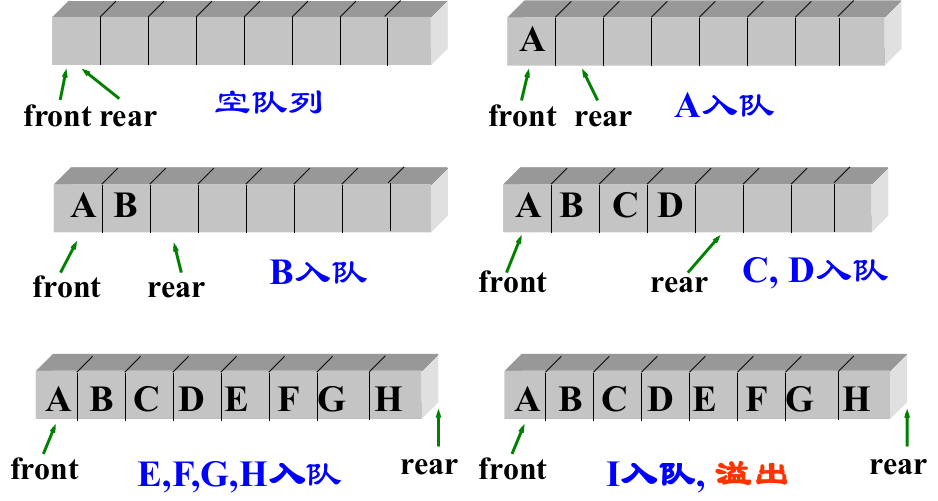
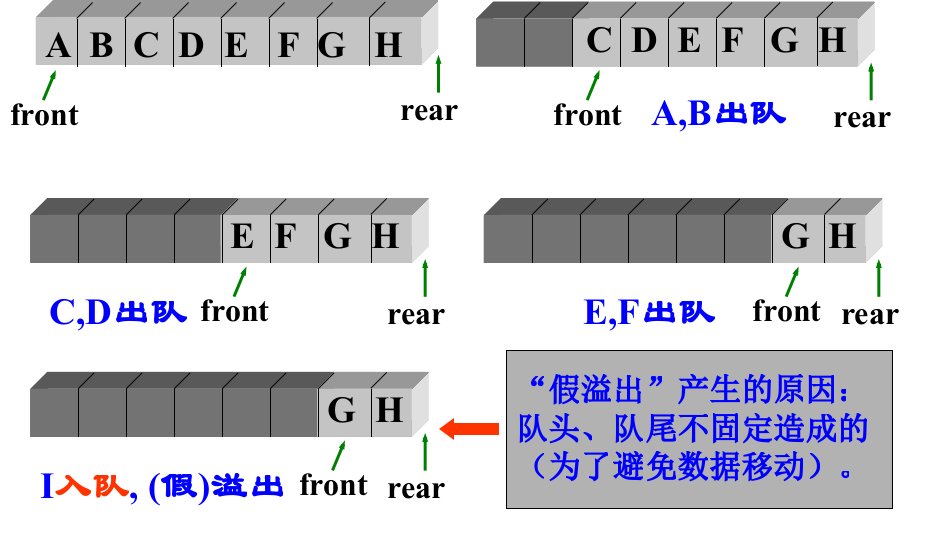
“假溢出”的解决方法
- 固定队头
- 出队方式发生改变:一个数据出队后,队列中其余数据均向前移动(包括 rear)。
- 入队方式不变。
- 固定队尾
- 入队方式发生改变:一个数据入队时,队列中其余数据先向前移动(包括 front),然后该数据入队尾。
- 出队方式不变。
上述两种方法的缺点:在入队和出队时需要移动队列中的所有数据元素。
- 循环队列
1. 基本思想:为了不移动数据,将队列设想成环形(首尾相接)。
2. 让 QueueList[0] 接在 QueueList[MaxQSize-1] 之后,若 rear==MaxQSize,则令 rear=0。
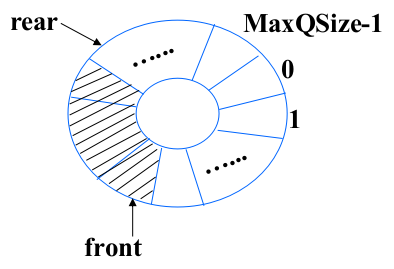
- 初始队列:front = rear = 0。
- 入队方式变为:当一个数据入队时,仍先将数据存入队尾 rear 指示的位置,然后 rear 执行如下操作:rear = (rear + 1) % MaxQSize。
- 出队方式变为:当一个数据出队时,仍先将队头 front 指示的数据取出,然后 front 执行如下操作:front = (front +1) % MaxQSize。
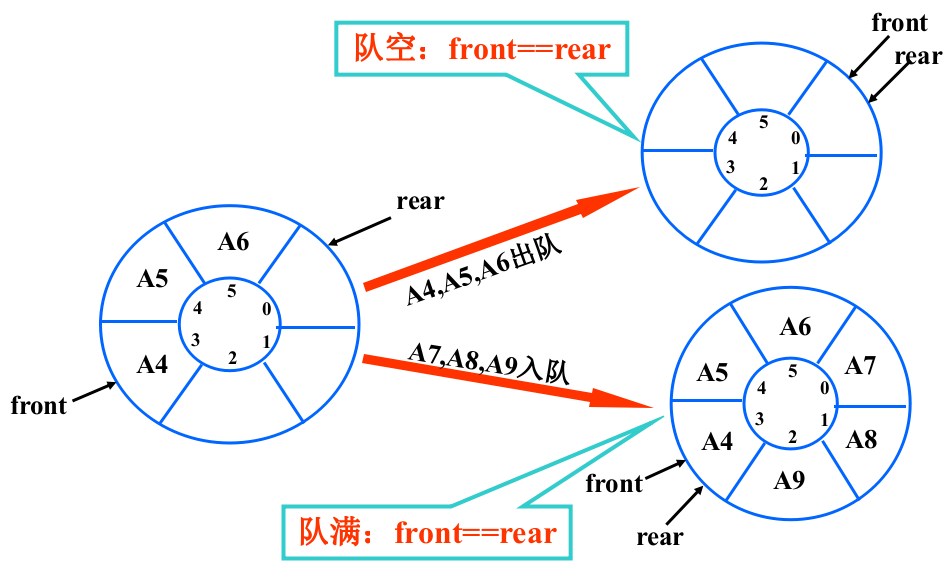
约定
- front==rear 时,表示队空
- 队尾的位置加 1 等于队头位置(队尾 rear 指向队头 front 的前一个位置)为队满的情况,因此队满的条件是 (rear+1) % MaxQSize==front 说明:这种处理方法使得队列中存在一个空单元。
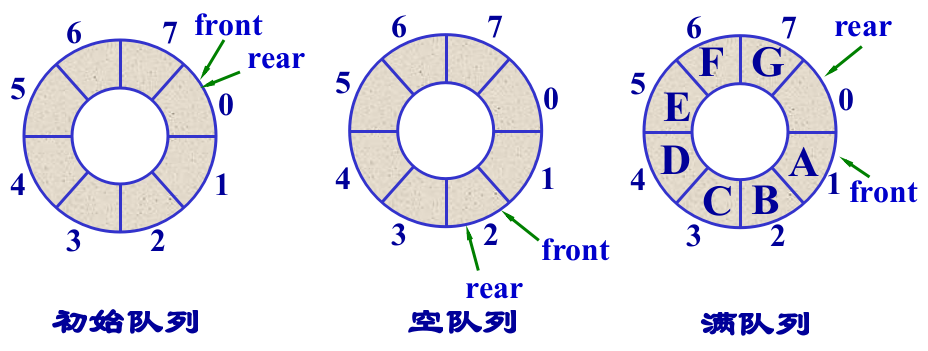
队列初始化:front = rear = 0;
队空条件:front == rear;
队满条件:(rear + 1) % MaxQSize == front;
  SeqQueue:SeqQueue( ){//构造函数,初始化一个空队列
      front=rear=0;
  } //SeqQueue
  void SeqQueue:ClearQueue( ) {  //清空队列
      rear=front;
  } //ClearQueue
  bool SeqQueue:IsEmpty( ) {    //判断队列是否为空
  if(rear==front)
      return true;
  else  return false;
  } //IsEmpty
  bool SeqQueue:IsFull( ) {    //判断队列是否已满
    if((rear+1)%MaxQSize==front)
        return true;
    else  return false;
  } //IsFull
  void SeqQueue:Enter(DataType item) {   //入队操作
       if(IsFull( )) //判断是否队满
               cout<<"队列已满,不能入队!"<<endl;
      else {
          QueueList[rear]=item;
          rear = (rear+1)%MaxQSize;
       }
  } //Enter
  DataType SeqQueue:Leave( ) {    //出队操作
   if(IsEmpty( )) {     //判断是否队空
         cout<<"队列已空,不能出队!"<<endl;
         return nulldata;
     }
     retvalue = QueueList[front];
     front = (front+1)%MaxQSize;
     return retvalue;
  } //Leave
算法分析:
- 以上有关循环队列的各种操作与队列中元素个数无关。
- 它们的时间复杂度均为 O(1)。
- 定义顺序队列时,应该知道所需的最大队列长度。
- 如果事先无法预知队列的最大长度,可以采用链式队列。
队列的链式存储表示 — 链式队列
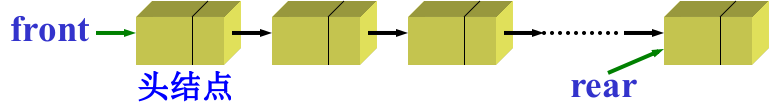
队头在链表头,队尾在链表尾。
链式队列在入队时无队满问题,但出队有队空问题。
对于带有头结点的链式队列的队空条件是 front→next NULL 或者 front rear。
  class QNode {  //链队列的结点类
    DataType  data;
    QNode *next;
   public:
     QNode(DataType item=nulldata) {
           data= item;
           next=NULL;
     }
     friend class LinkQueue;
  }; //QNode
  class LinkQueue {
     QNnode *front, *rear; //front指向头结点,rear指向真正队尾
  public:
      LinkQueue( ) { rear = front = new QNode( );  }
      void Enter(DataType item );   //入队
      DataType Leave( );        //出队
      DataType Front( );        //取队头元素
      void Clear( ); //清空队列
      bool IsEmpty() { return front –>next == NULL; }
   }; //LinkQueue
  void LinkQueue:Enter( DataType item ) {  //入队操作
     //将新元素item插入到队列的队尾
     rear->next = new QNode (item);
     rear=rear->next;
  }  //Enter
  DataType LinkQueue:Leave( ) {  //出队操作, 删去队头结点
      if(!IsEmpty( )){    //队不空
         p = front->next;
         DataType retvalue = p->data;    //保存队头的值
         front->next = p->next;
         delete p;
         if(front->next==NULL) //删除队列中唯一结点后,重新设置rear
               rear=front;
         return retvalue;
      }
      else   { cout<<"队列空!"<<endl;     return nulldata;   }
  }  //Leave
  DataType LinkQueue:Front( ) {       //取队头元素
      if(!IsEmpty( ))
         return front->next->data;
     else {
        cout<<"队列空,无队头元素!"<<endl;
        return nulldata;
    }
  } //Front
  void LinkQueue:Clear( ) {   //清空队列
     p=front->next;
     while(p) {
           front->next=p->next;
           delete p;
           p=front->next;
    }
    rear=front;
  }
栈与队列的应用
栈的应用
数制转换问题
将十进制数 N 转换为 r 进制的数,其转换方法利用辗转相除法:以 N=3467,r=8 为例转换方法如下:
得到的 8 进制数是按低位到高位的顺序产生的,而通常的输出是从高位到低位的,恰好与计算过程相反,因此转换过程中每得到一位 8 进制数可进栈保存,转换完毕后依次出栈即为转换结果。
当 N>0 时重复 (1) 和 (2)
- 若 N≠0,则将 N % r 压入栈 s 中,执行 (2);若 N=0,则将栈 s 中的内容依次出栈,算法结束。
- 用 N / r 的结果代替 N,返回 (1)。 算法描述如下:
  void conversion(int N,int r) {
   SeqStack  s;  int  x;
   while( N ) {
         s.Push(N % r);
         N=N / r ;
    } //while
    while (! s.IsEmpty( )) {
       x=s.Pop( );
       cout<<x;
    } //while
  } //conversion
表达式求值—中缀算术表达式
一个表达式由操作数 (亦称运算对象)、操作符 (亦称运算符) 和分界符组成。
运算符从操作数的个数上分为单目、双目和三目;从类型上分为算术运算符、关系运算符、逻辑运算符等。
在本应用中,只讨论由双目算术运算符构成的算术表达式的求值问题。
在计算机中,算术表达式有三种表示形式:
- 中缀 (infix) 表示: <操作数> <操作符> <操作数>,如 A+B;
- 前缀 (prefix) 表示 <操作符> <操作数> <操作数>,如 +AB;
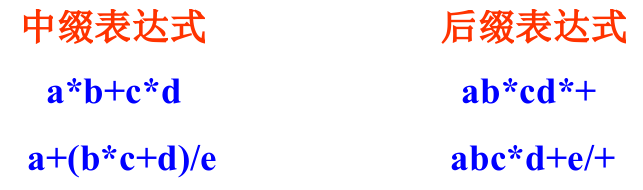
- 后缀 (postfix) 表示 <操作数> <操作数> <操作符>,如 AB+; 中缀表达式 a + b * ( c - d ) - e / f 后缀表达式 a b c d - * + e f / -
中缀算术表达式:每个双目算术运算符在两个操作数中间,假设此处讨论的双目算术运算符仅包括:+、-、*、/、^(乘方) 和括号 ( )。
表达式中相邻两个运算符的计算次序为: 优先级高的先计算;
- 优先级相同的自左向右计算; 当使用括号时从最内层括号开始计算; 乘方连续出现时先算最右面的。
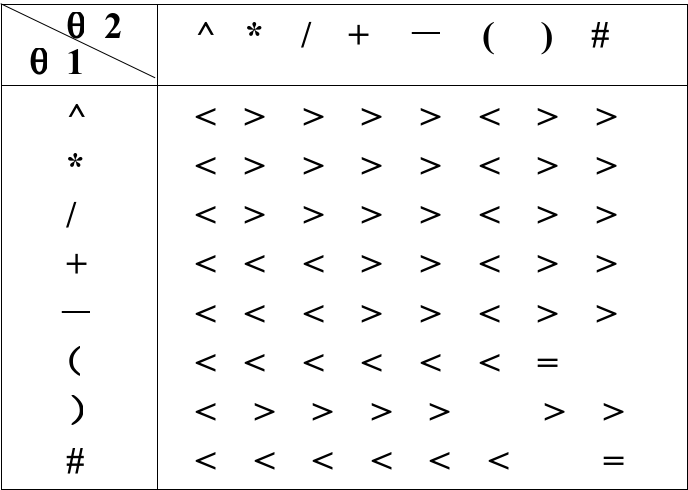
运算符间的优先关系 (1 和2 相继出现的运算符)
 算法思想:
设定两个栈:操作数栈 OPND,操作符栈 OPTR;
栈初始化:置操作数栈 OPND 为空;操作符栈 OPTR 中预设一个优先级最低的操作符 ’#’;
自左向右依次读入表达式的每个字符:是操作数则入 OPND 栈,是操作符则要进行如下判断:
- 如果 OPTR 的栈顶元素 (1)<读入的操作符 (2) ,则将操作符 (2) 入 OPTR 栈
- 如果 OPTR 的栈顶元素 (1)==读入的操作符 (2) 且1 不为 ’#‘,则从 OPTR 栈中弹出栈顶元素(括号运算符);否则,算法结束( 1= 2=’#’)
- 如果 OPTR 的栈顶元素 (1)>读入的操作符 (2) ,则操作数栈 OPND 弹出两个操作数,OPTR 栈弹出一个操作符进行计算,并将结果压入 OPND 栈。此时,不读取表达式,而是直接判断(1)~(3)。
计算中缀表达式:
3*2^(4+2*1)-5\#的值
| 读入的字符 | ** 操作数栈 s1** | ** 运算符栈 s2** | ** 说明** |
|---|---|---|---|
| 3 | 3 | # | 3 入栈 s1 |
| ***** | 3 | #* | *入栈 s2 |
| 2 | 3,2 | #* | 2 入栈 s1 |
| ^ | 3,2 | *^ | ^入栈 s2 |
| ( | 3,2 | *^( | (入栈 s2 |
| 4 | 3,2,4 | *^( | 4 入栈 s1 |
| + | 3,2,4 | *^(+ | + 入栈 s2 |
| 2 | 3,2,4,2 | *^(+ | 2 入栈 s1 |
| ***** | 3,2,4,2 | #^(+ | *入栈 s2 |
void EvaluateExpression(OperandType &result) {
//s1为操作数栈,s2为操作符栈,OP为运算符集合
//OP={‘^’, ‘*’, ‘/’, ‘+’, ‘-’, ‘(’, ‘)’, ‘#’};
SeqStack s1, s2;
s2.Push('#'); ch=cin.get( );
while((ch!='#')||(s2.GetTop( )!='#')) {
if (!In(ch,OP)) {
s1.Push(ch);
ch=cin.get( );
}
else
switch(compare(s2.GetTop( ), ch) //s2.GetTop( )为1, ch为2
{ case '<': s2.Push(ch); ch=cin.get( ); break;
case '=': s2.Pop( ); ch=cin.get( ); break;
case '>': temat=s2.Pop( );
b=s1.Pop( ); a=s1.Pop( );
result= Operate(a, temat, b);
s1.Push(result);
break;
} //switch
} //while
result=s1.GetTop( );
} //EvaluateExpression表达式求值—后缀算术表达式
后缀表达式:是运算符在操作数之后的形式,也称“逆波兰式”。
在编译器中,通常先将表达式的中缀形成转成后缀形式,然后再进行计算。
好处:后缀表达式无需括号,并且表达式的计算只需按运算符出现的顺序(从左至右)依次进行,不用考虑运算符的优先级。
如何得到后缀表达式?(这个问题留给大家去解决。)
在后缀表达式中,变量和数字仍然按其出现的顺序依次输入,而操作符(运算符)是在其操作数都已输入后再输入。
例如:表达式“a+bc”的后缀形式“abc+”
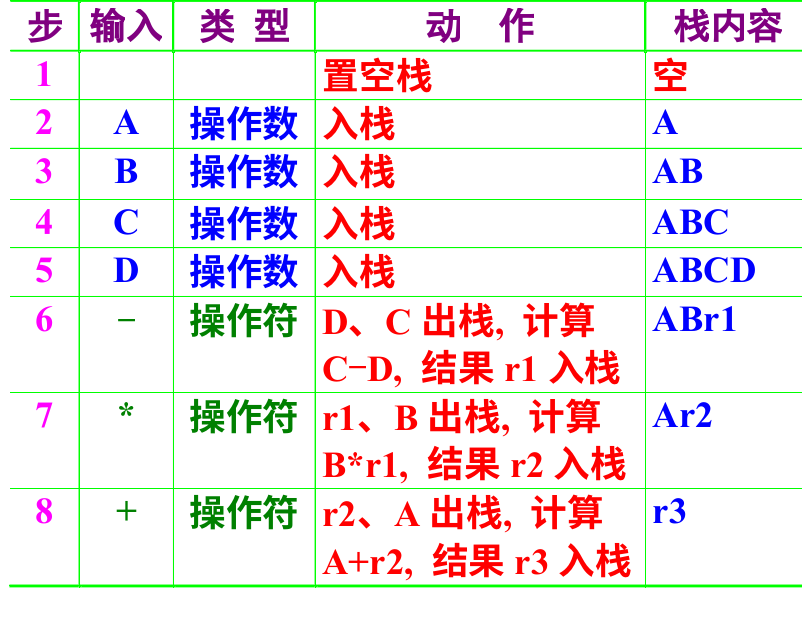
只需设定一个栈结构,并顺序扫描表达式的每一项,根据它的类型做如下相应操作:
若该项是操作数,则将其入栈;
若该项是操作符<op>,则连续从栈中退出两个操作数 Y 和 X,形成运算指令 X<op>Y,并将计算结果重新入栈。
当表达式的所有项都扫描并处理完后,栈顶存放的就是最后的计算结果。
例: ABCD- * + EF ^G / -
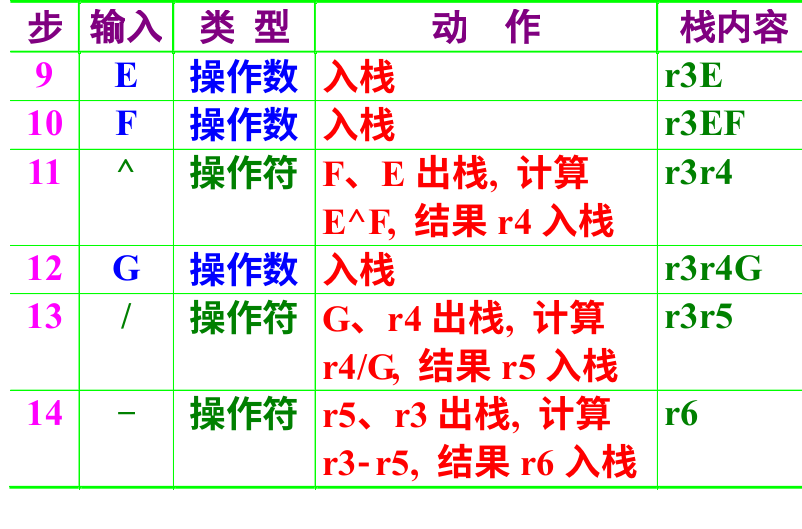
  void CalcuPostfix( OperandType &result) {
    //OP={‘^’, ‘*’, ‘/’, ‘+’, ‘-’, ‘#’};
    SeqStack s;    ch=cin.get( );
    while(ch!='#') {
          if (!In(ch, OP))      s.Push(ch);
          else  {
                    b=s.Pop( ); a=s.Pop( );
                    result= Operate(a, ch, b);
                    s.Push(result);
                    } //end else
         ch=cin.get( );
    } //end while
    return result;
  }
队列的应用
舞伴问题
舞会在星期五晚举行。舞会开始之前,参加舞会的男士和女士各自排队进入舞厅。舞会开始,从两队中按顺序组成舞伴开始跳舞。一曲结束后,男士和女士分别再进入各自队列。如果男士和女士人数不等,则多出的人只能等到下一舞曲开始。
要求用算法来模拟一支舞曲开始后男士和女士组成舞伴的情况,以及多少人在等待的情况。
用两个队列来表示男士和女士等待队列,舞会开始前时,按其性别加入不同队列,舞曲开始后,顺序地同时删除两个队列的元素来组成舞伴,直到某一队列为空。
  class  Person{               //Person为跳舞人的类
    char *name;
    char sex;                //F为男,M为女
  };
  void Dance_parnter() {
    SeqQueue  M_Dancer, F_Dancer;
    // M_Dancer为男士队列,F_Dancer为女士队列
    Person p;                  //Person为跳舞人的类
    Person_arrive(p,name,sex);
     //有人到达舞会,将其姓名和性别赋给p
     //p.name=name; p.sex=sex;
  //根据来人的性别建立男士队列和女士队列
  while(strcmp(p.name,"#")<>0) {
   //将男士和女士分别入各自队列
   if (p.sex= ='F')
       F_Dancer.Enter(p);
   else
       M_Dancer.Enter(p);
   Person_arrive(p, name, sex);
  } //while
  if(!M_Dancer.IsEmpty( )){    //女士队列为空
         cout<<"There are "<<M_Dancer.Length( )<<
              " men  waiting for the next round."<<endl;
  }
  else if(!F_Dancer.IsEmpty( )){   //男士队列为空
         cout<<"There are "<<F_Dancer.Length( )<<
              " women waiting for the next round."<<endl;
  }
  } //Dance_partner
P76: 2 P77: 4,5-(1) 上机实验:实验 2、实验 3
  练习题1
  void  main( )  {
      Queue  Q;
      char  x='e';  y='c';
       Q.Enter('h');  Q.Enter('r');
       Q.Enter(y);   x=Q.Leave();
       Q.Enter(x);   x=Q.Leave();
       Q.Enter('a');
       while(!Q.IsEmpty())  {
           y=Q.Leave();
           cout<<y;    }
        cout<<x;
  }
线性表
线性结构
线性表,数组和第三章中的栈、队列都属于线性结构。
特点
- 具有唯一的第一个数据元素 (无前驱);
- 具有唯一的最后一个数据元素 (无后继) ;
- 其他数据元素都有且仅有一个前驱和一个后继。
线性表 (Linear List)
由 n(>=0) 个性质相同的数据元素组成的有限序列,记作:L=(a1, a2, …, an)其中:ai 是表中的第 i 个数据元素,n 是表长度。
注意: 数据元素的个数 n 被定义为表的长度。当 n=0 时,称为空表。 这里的数据元素 ai(1in) 只是一个抽象的符号,其具体含义在不同情况下可以不同。
特点(非空线性表):
- 有且仅有一个开始结点 a1,它没有 (直接) 前趋,但仅有一个 (直接) 后继 a2;
- 有且仅有一个终端结点 an,它没有 (直接) 后继,但仅有一个 (直接) 前趋 an-1;
- 其余的内部结点 ai(2⇐ i ⇐n-1) 都有且仅有一个 (直接) 前趋 ai-1 和一个 (直接) 后继 ai+1。 线性表是一种典型的线性结构。
抽象数据类型(ADT)线性表:
ADT List{
Data //数据元素表:是n(n 0)个数据元素的一个有限序列,其中每个数据元素的数据类型为
DataType
size//数据元素的个数
Operation
Constructor
Process//创建空表
Clear
Process//清空线性表
IsEmpty
Process//判断线性表是否为空
Output//若线性表为空, 返回true, 否则返回false
Length
Process//求线性表中元素个数
Output//返回线性表中元素个数
Get
Input//要取出的元素的位置
Process//取出指定位置上的元素
Output//返回取出的元素值
Locate
Input//要定位的元素
Process//为指定元素定位
Output//若线性表中有给定元素,返回元素位置,否则返回-1
Insert
Input//被插入元素值及其位置
Process//将给定元素插入指定位置
Delete
Input//被删除元素的位置
Process//若线性表中有给定元素,则删除它
Prior
Input//要求前驱的元素
Process//求给定元素的直接前驱
Next
Input//要求后继的元素
Process: 求给定元素的直接后继
} //List顺序表 (SeqList)
把线性表的元素按逻辑顺序依次存放在一组地址连续的存储单元里。
存储结构与逻辑结构的 0 关系:
以“存储位置相邻”表示有序对<ai-1,ai>,即:
LOC(ai)=LOC(ai-1)+m。
任一个数据元素的存储位置均取决于第一个数据元素的存储位置:
LOC(ai) = LOC(a1) + (i -1)×m
存储结构与逻辑结构的关系
一维数组在内存中都对应着一组连续的存储单元,因此常用一维数组来表示线性表的顺序存储结构。
顺序表 (SeqList) 实现
  const  int  MaxListSize=100;
  class SeqList{
  DataType data[MaxListSize]; //一维数组实现的线性表 && 实际问题中数据元素的类型。
  int size;            //元素的个数
  public:
  SeqList( ){size = 0;}     //构造一个空线性表
  void Clear( );        //清空表
  bool IsEmpty( );     //判断如果为空表,返回true,否则返回false
  DataType Get(int k){return data[k];}    //返回第k个元素
  int Locate(DataType e);      //返回第一个与元素e匹配的元素位序
  DataType Prior(DataType e);   //返回元素e 的前驱
  DataType Next(DataType e);    //返回元素e 的后继
  void Insert(DataType e, int i);   //在表中第 i 个位置插入新元素e
  DataType Delete(int i);        //删除第i个元素,并返回其值
}; //SeqList- 插入算法
  void Insert(DataType e, int i){
  if ( i < 0 || i >size || size = = MaxListSize  )
  // i不合法或顺序表已满;
   exit;
  else {
   size++;
   for (j=size-1; j>i; j-- )
       data[j] = data[j-1];
   data[i] = e;  //插入成功
  }
  } //Insert
插入算法的时间复杂度: (n-1)/2
该算法的时间主要消耗在移动元素上。
平均情况:设插入每个位置的概率相等,则数据元素的平均移动次数:
插入算法的时间复杂度为:O(n)
- 删除算法
  DataType Delete( int i ){
  if (i<0 || i>= size)
      return nulldata; //被删除元素的下标不合法
  else{
       e=data[i];
   for ( int j=i; j<size; j++ )
            data[j] = data[j+1];
       size--;
       return e;
   }
  } //Delete
删除算法的时间复杂度: (n-1)/2
平均情况:设删除每个数据元素的概率相等,则移动数据元素的平均次数为:
删除算法的时间复杂度为:O(n)
- 查找 (定位) 算法
  int Locate(DataType e){
  int  i = 0;
  while ( i<size && data[i]!=e )
       i++;
  if ( i >=size )
     return -1; //没有找到
  else
      return i; //找到此元素,返回其下标
  } //Locate
基本操作: 比较
查找不成功: 比较 n 次
最好情况: 比较 1 次, O(1)
最坏情况: 比较 n 次, O(n)
成功时:
平均情况: 设查找每个数据元素的概率相等,则
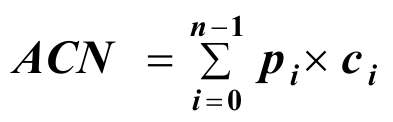
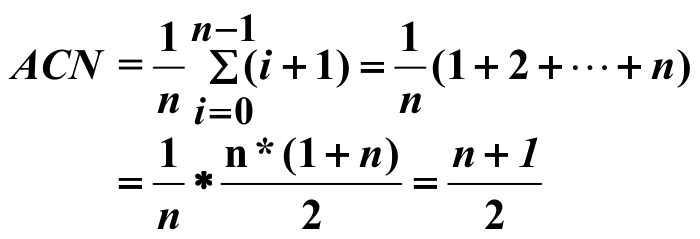
时间复杂度:O(n)
优点
- 无需为表示数据元素之间的逻辑关系而增加额 外存储空间。
- 可方便地随机存取表中任一元素。 顺序表的缺点:
缺点
- 预先为数据元素分配空间。
- 插入和删除时必须移动大量元素。
链式存储
逻辑上相邻的元素,其物理位置不一定相邻。
数据元素之间可以连续存储,也可以不连续存储;
数据元素的逻辑顺序与物理顺序可以不一致;
特点:长度可扩充。
单链表
- 每个结点只有一个指针域且最后一个结点的指针域为空。
- 整个单链表可由头指针唯一确定。
- 为了操作(插入和删除)方便,增设一个头结点。 注意区分: 头结点 && 首结点 && 头指针
  class Node {  //结点类
    DataType  data;
    Node   *next;
  public:
    Node( ) { next=NULL; }
    friend class LinkList; //声明友元类
  }; //Node
  class  LinkList {             //链表类
    Node *head;          //头指针
    int size;                  //结点个数,头结点不计入其中
  public:
    LinkList( ) { head=new Node(); size=0; }
    void Create(int n);     //创建长度为n的单链表
    DataType Get(int i);    //返回第i个元素值
    Node* Locate(DataType e); //返回第一个与e匹配的
                                                       //元素结点指针
    bool IsEmpty( ) //判断是否为空链表
    {  return (head->next==NULL); }
  void Insert(DataType x, int i);  //在第i个结点之前插入元素值为x的结点
  Datatype Delete(int i); //删除第i个结点
  void Clear( ); //清空链表
  DataType Prior(DataType e); //返回e的前驱结点元素
  DataType Next(DataType e); //返回e的后继结点元素
  }; //LinkList
  DataType LinkList:Get(int i){ //取元素
  if( head->next==NULL)    //空链表,返回空值
    return nulldata;
  else {
    p=head; k=0;
    while(p&&k<i)
    {  p=p->next;  k++;  }
    if(!p || k==0)  return nulldata;  // i超出链表的范围
    else  return  p->data;
  }
  } //Get
插入结点
- 在链表最前端插入
  newnode->next = head->next;
head->next = newnode;- 在链表中间插入
  newnode->next = p->next;
p->next = new node;- 在链表末尾插入
  newnode->next = p->next;
  p->next = newnode;
void LinkList: Insert ( DataType x, int i ) {
//在第i个结点之前插入元素值为x的结点
Node* p = head; int k = 0;
if(i<1 || i>size) exit; // 插入位置错误
while ( p && k< i -1 )
{ p = p->next; k++; } //找到插入位置
if(!p) exit; //插入位置无效
Node* newnode= new Node( );
newnode->data=x;
newnode->next=p->next;
p->next=newnode; size++;
} //Insert删除结点
删除操作是将表的第 i 个结点删去。 删除过程:1)定位;2)删除。
p→next = q→next; delete q;
  DataType LinkList:Delete(int i)
  { //删除第i个结点
  Node* p = head; int k=0;
  if(i<1 ||i>size)     // 结点序号i超出链表结点范围,返回空值
  return nulldata;
  while ( p && k< i-1 )   //找到被删除结点的前一个元素
  { p = p->next;  k++; }
  if ( !p ) {
  cout << “Invalid position for Deletion!\n”;
  return nulldata;
  }
  q = p->next;    p->next = q->next;
  e= q->data;
  delete q;
  size--;    return e;
  } //Delete
建立单链表
建立单链表的常用方法有如下两种: 头插法建表 该方法从一个空表开始,重复读入数据,生成新结点,将读入数据存放到新结点的数据域中,然后将新结点插入到当前链表的表头上,直到读入结束标志为止。
  void LinkList:Create( DataType  endTag){ //头插法建表   DataType  value;    head=new Node( );   //创建头结点
  head->next=NULL;
   cin>>value;
  while (value!=endTag) {
      size++;
      Node *p=new Node( );
      p->data=value;
      p->next=head->next;
      head->next=p;
      cin>>value;      }//while
  }
尾插法建表
头插法建立链表虽然算法简单,但生成的链表中结点的次序和输入的顺序相反。若希望二者次序一致,可采用尾插法建表。 该方法是将新结点插入到当前链表的表尾上,为此必须增加一个尾指针 r,使其始终指向当前链表的尾结点。
- 创建头指针 head,使尾指针 r=head;
- 新建结点 p,如果 head→ next = NULL, 则 head→ next =p;r=p;
- 否则,r→ next =p; r=p; 重复(2)、(3)实现尾插法;
- 如果 r!= NULL; 则 r→ next =NULL;
尾插法建立单链表
  void LinkList: Create(DataType  endTag) {
    Node  *p, *r;      head=new Node( );
    head->next=NULL;    r=head;          //尾指针
    cin>>value;
    while (vauel!=endTag) {
       size++;
       p=new Node( );
       p–>data=value;
       r–>next=p;
       r=p;
       cin>>value;   }//while
       r-> next =NULL;
  } //Create
(单) 循环链表
循环链表基本操作的实现 基本操作与单链表类似 考虑在循环链表中如何判断遍历链表的终止条件?
p→next==NULL?
应该是 p→next==head
双向链表
双向链表:在单链表的每个结点里再增加一个指向其直接前趋结点的指针域,这样形成的链表中有两个不同方向的链,故称为双向链表。
双向链表的结点结构:
双向循环链表
双向循环链表:首尾相连的双向链表。
双向循环链表的结点结构与双向链表一致:
带头结点的双向循环链表
结点指向 p
  p→prior→next
  p→next →prior
带头结点的双向循环链表类的定义
  class DNode{     //双向循环链表中结点定义
  DataType data;
  DNode *prior;               //指向前驱的指针
  DNode *next;                //指向后继的指针
  public:
  DNode(DataType d=nulldata)
  {
     data=d;
     prior=next=NULL;
  }
  friend class DBList;
  }; //DNode
  class DBList{                   //双向循环链表的定义
   DNode *head;
   int size;
  public:
  DBList(){head=new DNode(); size=0;}   //构造函数,创建空链表
  void Create(int n);             //创建长度为n的双链表
  DataType GetElem(int i);       //取得第i个元素
  DNode* Locate(DataType e); //返回第一个与e匹配的结点指针
  bool IsEmpty( );        //判断是否为空链表
  void Insert(DataType e, int i);  //在第i个结点前插入元素为e的结点
  DataType Delete(int i);       //删除第i个结点,并返回其元素值
  void Clear( );                //清空链表
  }; //DBList
查找算法
搜索成功
搜索不成功
删除算法
current ->prior->next= current ->next;- current →prior→next= current →next;
- current →next→prior= current →prior;
- current →prior→next= current →next;
- current →next→prior= current →prior;
- delete current ;
双向循环链表的插入算法
- p→prior=current;
- p→next= current →next;
- current→next→prior=p;
- current→next=p; 交换语句 3 和语句 4 将导致反向链表连接不正常。
- current→next=p; 4. current→next→prior=p; 注意: 与单链表的插入和删除操作不同 的是,在双向(循环)链表中插入和删除必须同时修改两个方向上的指针。
顺序表和链表的比较
顺序表
没有附加存储空间开销
随机取得任一元素
预先申请固定长度的数组
插入、删除需要移动元素,运算时间代价 O(n)
链表
插入、删除运算时间代价 O(1)
在运行时动态为表中新的元素分配存储空间
顺序取得某一元素
每个元素都有附加存储空间开销(指向下一个结点的指针)
根据实际应用选择顺序表和链表
顺序表
结点总数目大概可以估计
表中结点比较稳定(插入、删除操作少)
链表
结点数目无法预知
线性表中结点动态变化(插入、删除操作多)
一元多项式求和算法
实例:一元多项式的链表表示
在一元多项式的链表表示中每个结点包含三个数据成员:
优点: 多项式的项数可以动态增长,不存在存储溢出问题。 插入、删除方便,不移动元素。 扫描两个多项式链表(多项式链表按指数递增排序),若都未检测完: 若当前被检测项指数相等,则系数相加,若不为 0,则将结果添加到结果多项式;并且两个多项式指针均后移。 若当前被检测项指数不等,则将指数小者加到结果多项式,并且指针后移。 若一个多项式已检测完,则将另一个多项式剩余部分全部复制到结果多项式。
  下面给出一元多项式的结构说明。
  class PNode
  { //结点的定义
   float coef;  //系数
  int expn;  //指数
   PNode * next;
  public:
   PNode(float c=0, int e=0)
   {
  coef=c; expn=e; next=NULL;
   }
  friend class PolynList;  //友元类
  }; //PNode
  class PolynList{            //多项式链表定义
      PNode* head;
      int len;
  public:
  PolynList( ){head=new PNode();} //构造空的多项式链表
  void Create(int m);        //创建m项多项式
  void AddPolyn(PolynList&); //多项式相加
  void PrintPolyn( );          //显示多项式
  void SubstractPolyn(PolynList&); // 多项式相减
  void MultiplyPolyn(PolynList&); // 多项式相乘
  }; //PolynList
  void PolynList:Create(int m)
  {
  float  c;      int e;
  p=head;
  for(int i=0; i<m; i++)
      {
            cin>>c>>e; //假设输入的多项式按指数递增
     p->next=new  PNode(c, e);
             p=p->next;  //尾插法
  }
  }
  两个多项式相加算法(多项式B加到A上):
  void PolynList:AddPolyn (PolynList &bh) {
   pc=this->head;  pa=this->head->next;  pb=bh.head->next;
   delete bh.head;
   while (pa && pb) {
      a=pa->term.expn; b=pb->term.expn;    //指数
      if (a<b){    // 多项式ah(this指针)中当前结点的指数值小
           pc->next=pa; pc=pa; pa=pa->next; //pa指针后移
        }
       else  if (a>b){  //多项式bh中当前结点的指数值小
           pc->next=pb; pc=pb; pb=pb->next; //pb指针后移
        }
  else if(pa->term.coef+pb->term.coef==0){
         //两个结点系数之和为0,分别删除这两个结点;
         p=pa; pa=pa->next; delete p;
         p=pb; pb=pb->next; delete p;
   }
   else{ //将pb结点的系数加入pa结点
          pa->term.coef=pa->term.coef+pb->term.coef;
          pc->next=pa; pc=pa; pa=pa->next;
          p=pb; pb=pb->next; delete p;
    }
  } //while
  if(pa) pc->next=pa; //pb遍历完毕,将pa加到pc上
  else pc->next=pb; //pa遍历完毕,将pb加到pc上
  }
数组 (Array)
由一组类型相同的数据元素构成的有限序列,且该有限序列是存储在一块地址连续的内存单元中。 数据元素可以是整数、实数等简单数据类型,也可以是结构体、类等构造数据类型。 在数组中的各数据元素是由其下标来区分的。 当数组中的每个数据元素只有一个下标时,这样的数组称为一维数组。 将一维数组中各数据元素的下标按顺序变成线性表中的序号,则一维数组就是一个线性表(顺序表)。 当一个数组的每个数据元素都含有两个下标时,该数组称为二维数组。 当一个数组的每个数据元素都含有 n 个下标时,该数组称为 n 维数组。
特别地,
一个二维数组可以看作每个数据元素都是一个一维数组的一维数组。
一个二维数组可以看作每个数据元素都是一个一维数组的一维数组。
二维数组中的每个元素 aij 都属于两个线性表:第 i 行的线性表 Bi 和第 j 列线性表 Aj。
因此,受两个下标的约束,二维数组中的每个元素 aij 最多有两个直接前驱和两个直接后继. a00 没有直接前驱,称之为开始结点,an-1,m-1 没有直接后继,称之为终端结点。 第 0 行的元素 a0j (j=1,…,m-1) 和第 0 列的元素 ai0 (i=1,…,n-1) 都只有一个直接前驱。 第 n-1 行的元素 an-1,j(j=1,…,m-2) 和第 m-1 列的元素 ai,n-1(i=1,…,n-2) 都只有一个直接后继。aij(1≤i ≤n-2,1 ≤j ≤m-2) 都有两个直接前驱结点 ai,j-1, ai-1,j 和两个直接后继结点 ai,j+1, ai+1,j。
三维数组和 N 维数组
同理,三维数组 Am×n × l 中每个元素属于三个线性表,每个元素最多有三个直接前驱和三个直接后继。 Ai1,i2,i3 前驱: Ai1-1,i2,i3 , Ai1,i2-1,i3, Ai1,i2,i3-1
后继: Ai1+1,i2,i3 , Ai1,i2+1,i3, Ai1,i2,i3+1
推而广之 ,n 维数组 Ab1 ×b2 ×… ×bn 中每个元素属于 n 个线性表,每个元素最多有 n 个直接前驱和 n 个直接后继。 Ai1,i2,…,in
前驱:Ai1-1,i2,…,in, Ai1,i2-1,…,in,…, Ai1,i2,…,in-1
后继:Ai1+1,i2,…,in, Ai1,i2+1,…,in,…, Ai1,i2,…,in+1
存储
在计算机中通常都采用顺序存储——数组的定义。 由于计算机中的存储空间(地址)是一维的,因此存放多维数组时,必须按照某种次序将数据元素排成一个一维序列。 对于多维数组,有一个次序约定的问题。 例如:二维数组可以按行顺序存储,即:先存放第 0 行元素,再存放第 1 行元素,依次类推;也可以按列顺序存储。 规定好次序,所有数据元素都可依次存放到一块地址连续的存储空间中。 只要给出一组下标,便可求出相应数据元素的存储地址(位置)。
用处
- 在图像处理中,经常开辟一个一维数组来存放图像数据;
- 为了能按图像中像素的坐标获得像素的颜色,需要计算存储地址。
方法
每个元素占用 l 的存储单元。
- 一维数组:顺序存储
- a
- LOC(i) = LOC(i-1)+l = a+i*l
- 二维数组:
- 顺序存储 行优先存放:设数组开始存放位置 LOC(0,0)=a, 每个元素占用 l 个存储单元,则数据元素 (i, j) 的存储地址为
- LOC ( i, j ) = a + ( i * m + j ) * l
- 列优先存放:设数组开始存放位置 LOC(0,0) = a, 每个元素占用 l 个存储单元,则数据元素 (i, j) 的存储地址为
- LOC ( i, j ) = a + ( j * n + i ) * l 3. 三维数组: 各维元素个数为 m1, m2, m3。 下标为 i1, i2, i3 的数据元素的存储地址:(按页/行/列存放)
- LOC ( i1, i2, i3 ) = a + ( i1* m2 * m3 + i2* m3 + i3 ) * l
- LOC ( i1, i2, …, in ) = a +( i1_m2_m3_…mn + i2_m3_m4…_mn+……+ in-1_mn + in ) _ l
特殊矩阵
非零元素或零元素的分布有一定规律的矩阵。
对称矩阵;
对角矩阵(带状矩阵);
稀疏矩
与压缩存储
压缩存储主要是针对特殊矩阵,为节省存储空间,对可以不存储的元素,如零元素或对称元素,不再存储。 对称矩阵的压缩存储
设有一个 nn 的对称矩阵 A。 在矩阵中,aij = aji
为了节约存储,只存对角线及对角线以上的元素,或者只存对角线及对角线以下的元素。前者称为上三角矩阵,后者称为下三角矩阵。 为了节约存储,只存对角线及对角线以上的元素,或者只存对角线及对角线以下的元素。前者称为上三角矩阵,后者称为下三角矩阵。
把所需元素按行存放于一个一维数组 B 中,称之为对称矩阵的压缩存储。 一维数组 B 共有 n + ( n - 1 ) + + 1 = n*(n+1)/2 个元素。 问题:压缩存储之后,如何在一维数组 B 中定位矩阵中的任意数据元素?
若 i ≤ j,数组元素 a[i][j] 在数组 B 中的存放位置为 + j-i
若 i j, 数组元素 a[i][j] 在数组 B 中的存放位置为 1 + 2 + + i + j = (i + 1)* i / 2 + j
稀疏矩阵 (Sparse Matrix)
矩阵 A 中有 s 个非零元素,若 s 远远小于矩阵元素的总数(即 s << m×n),而且这些非零元素的分布也没有规律。
优点: 节省了存储单元
缺点: 失去了随机存取功
实现
存储稀疏矩阵时,为了节省存储单元,可采用只存储非零元素的压缩存储方法。 有两种实现方式:
- 三元组顺序表——顺序存储
- 由于非零元素的分布没有规律,所以在存储非零元素时,需要同时存储该非零元素的行下标 row、列下标 col、值 value。 每一个非零元素可由一个三元组唯一确定
- 元素按行递增排序存放的,当行相等时是按列递增排序存放的。
- 十字链表——链式存储
  const int SMax=1024;
  class  SPNode{        //三元组类
   int i, j;                //非零元素的行、列
   DataType  v;    //非零元素值
   friend class SPMatrix;   //声明友元类
  }; //SPNode
  class SPMatrix{       //三元组表类
   int rn, cn, en;    //矩阵的行、列及非零元素的个数
   SPNode data[SMax];   //三元组顺序表
  public:
    SPMatrix( );
    SPMatrix(int m, int n, int s); //构造m行n列含s个非零元素的稀疏矩阵
    SPMatrix Transpose( );          //求转置矩阵
    SPMatrix Add(SPMatrix&);   //求矩阵的和
    SPMatrix Multiply(SPMatrix&);   //求矩阵的乘积
  }; //SPMatrix
  求转置矩阵算法
  for (col=0; col<nu; ++col)
      for (row=0; row<mu; ++row)
          b[col]\[row] = a[row]\[col];
  nu是a的列数(b的行数) mu是a的行数(b的列数)
  其时间复杂度为: O(mu×nu)
转置
问题:若采用三元组顺序表存储稀疏矩阵,只要把每个元素的行下标和列下标互换,就完成了对该矩阵的转置运算,这种说法正确吗?
思路:
- 每个元素的行下标和列下标互换(即三元组中的 i 和 j 互换)
- a 的总行数 mu 和总列数 nu 赋为 b 的总列数和总行数
- 重排三元组表内元素的顺序,使转置后的三元组也按行(或列)优先顺序排列。 实现:压缩转置 思路:反复扫描 a.smArray 中的列序,从小到大依次进行转置。
  稀疏矩阵的压缩转置算法:
  SPMatrix SPMatrix:Transpose( ){
  SPMatrix T;
  T.rn=cn; T.cn=rn; T.en=en;  //将行数、列数、非零元个数赋给T
  if(en){
   q=0;
   for(col=0;col<cn;++col)
      for(p=0;p<en;++p)
         if(data[p].j==col){
            T.data[q].i= data[p].j;  T.data[q].j= data[p].i;
            T.data[q].v=data[p].v;
             ++q;
        }     }
  return T;
  }  //Transpose
主要时间消耗在查找 data[p].j==col 元素, 由双重循环完成: for(col=0;col<cn;++col) 循环次数=cn //cn 为列数 for(p=0;p<en;++p) 循环次数=en //en 为非零元素个数 所以该算法的时间复杂度为 O(cnen) ---- 即 a 的列数与 a 中非零元素的个数之积 最坏情况:a 中全是非零元素,此时 en=cnrn, //rn 为行数 时间复杂度为 O(cn2rn) 而用非压缩传统转置算法的时间复杂度也不过是 O(cnrn) 结论:压缩转置算法不能滥用。 前提:仅适用于非零元素个数很少(即 en<<rn*cn)的情况。
稀疏矩阵的十字链表
三元组顺序表能够实现稀疏矩阵的压缩存储,并且适用于求稀疏矩阵的转置等运算,但对于另外一些运算,如矩阵加法、乘法等,在运算的过程中矩阵的非零元素的个数和位置经常发生改变,因此三元组顺序表不适合这些运算。 可采用链式存储结构——十字链表来实现稀疏矩阵的压缩存储。
十字链表 每个非零元素用一个含 5 个域的结点表示: 其中:row、col 和 val 三个域分别表示该非零元素所在的行、列以及它的值;right 域用来指向同一行中的下一个非零元素;down 域用来指向同一列中的下一个非零元素。
每个非零元素用一个含 5 个域的结点表示: 这样,right 域可将稀疏矩阵中同一行上的非零元素链接成一个链表;down 域可将稀疏矩阵中同一列上的非零元素链接成一个链表。
每个非零元素用一个含 5 个域的结点表示: 每个非零元素既是某个行链表上的结点,同时又是某个列链表上的结点,整个稀疏矩阵将构成一个十字交叉的链表——十字链表。
课后习题: p51:2 p53:5-(1), 5-(2), 5-(5) 上机实验:实验 1
树
树的定义
树是由 n (n ≥ 0) 个结点组成的有限集合。树是一种典型的“层次结构”,体现出“一对多”的关系。
如果 n = 0,称为空树;
如果 n > 0,则
- 有一个特定的称之为根 (root) 的结点,它只有直接后继,没有直接前驱;
- 除根以外的其他结点被划分到 m (m ≥ 0) 个 互不相交的子集 T1, T2, …, Tm 中,每个子集又都构成一棵树,称之为根的子树 (sub tree)。
相关术语
直接前驱 / 直接后继。
双亲、子女(parent, child)
结点的度(degree)
叶子(leaf)
分枝结点(branch node)
树的度
结点所在的层次 (level)
深度或高 (depth): 深度自上到下, 高自下而上.
兄弟 (sibling)
堂兄弟 (cousin)
祖先(descendant) 、子孙(ancestor)
路径(path)
有序树(ordered tree)
森林 (Forest)
二叉树 (Binary Tree)
一个结点的有限集合,该集合或者为空,或者是由一个根结点加上两棵分别称为左子树和右子树的、互不相交的二叉树组成。
ADT 描述
  ADT BinaryTree {
  Data   是有限个结点的集合D。当D非空时,其中
           有一个根结点t,其余结点被分为t的左子树和
           右子树。
  Operations
     Constructor
         Process: 建立一棵空二叉树
     Delete
         Process: 删除二叉树
  IsEmpty
    Process: 判断二叉树是否是空
    Output: 若二叉树为空,则返回true, 否则返回false
  Size
    Process: 计算二叉树的结点个数size
    Output: size
  Height
    Process: 计算二叉树的高度height
    Output: height
  Root
    Process: 取二叉树根结点的值x
    Output: 根结点的值x
  Parent
    Input: node是二叉树中的一个结点
    Process: 求node的双亲p,若node 是根,则p为空
    Output: p
  CreateBinaryTree
    Input: 二叉树的某种形式的定义
    Process: 根据此定义构造二叉树
  MakeTree
    Input: data是根结点值,left是左子树,right是右子树
    Process: 创建二叉树,data是根结点值,left是其左子树,
                    right是其右子树
  BreakTree
    Process: 拆分二叉树,data是根结点数据,left是左子树,
                    right是右子树
    Output: data, left, right
  PreOrder
    Input: Visit( )是结点访问函数
    Process: 前序遍历,对二叉树中每个结点仅调用一次Visit( )
    Output: 根据Visit( ),得到前序遍历的结果
  InOrder
    Input: Visit( )是结点访问函数
    Process: 中序遍历,对二叉树中每个结点仅调用一次Visit( )
    Output: 根据Visit( ),得到中序遍历的结果
  PostOrder
    Input: Visit( )是结点访问函数
    Process: 后序遍历,对二叉树中每个结点仅调用一次Visit( )
    Output: 根据Visit( ),得到后序遍历的结果
  LevelOrder
    Input: Visit( )是结点访问函数
    Process: 按层次对二叉树中每个结点仅调用一次Visit( )
    Output: 根据Visit( ),得到层次遍历的结果
  } //BinaryTree
完全二叉树 (Complete Binary Tree)
若设二叉树的高度为 h,则共有 h 层。除第 h 层外,其它各层 (1 - h-1) 的结点数都达到最大个数,第 h 层是将满二叉树从右向左连续去除若干结点,这就是完全二叉树。
叶结点仅在层次数最大的两层出现;
对任一结点,若其右子树的高度为 l,则其左子树的高度为 l 或 l+1。
遍历
1. 前序 (VLR)
2. 中序 (LVR)
3. 后序 (LRV)
性质
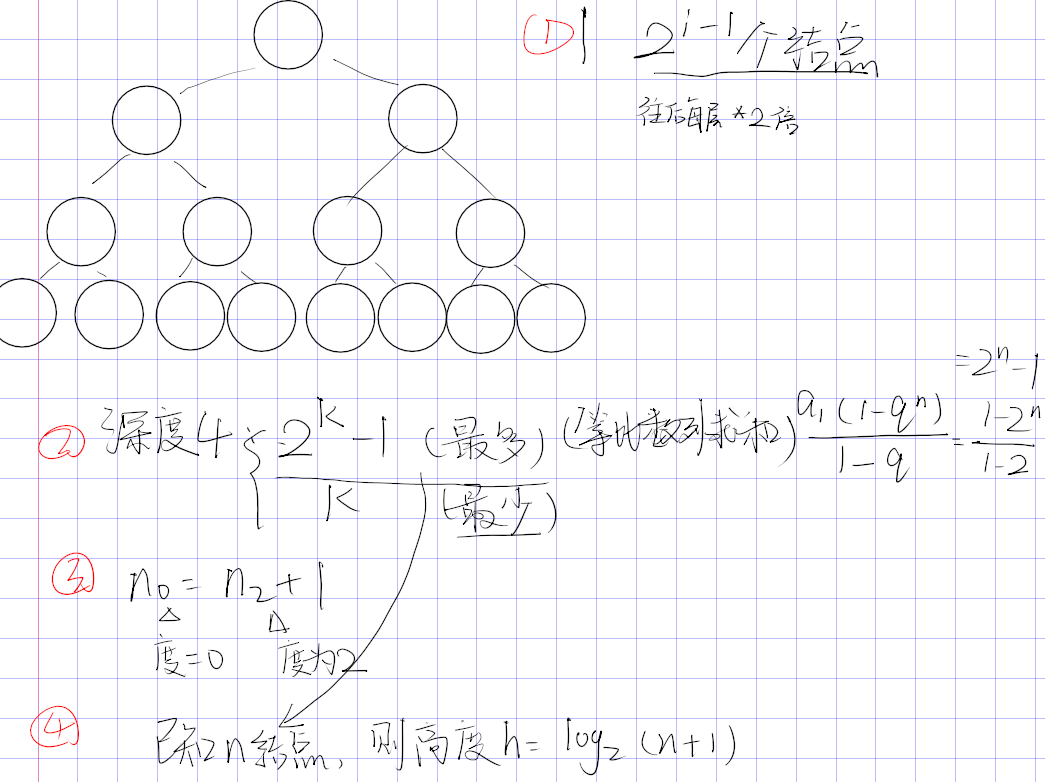
- 若二叉树的层次从 1 开始, 则在二叉树的第 i 层最多有 2 个结点。(i ≥ 1)
- [证明用数学归纳法]
- 深度为 k 的二叉树最多有 2 个结点, 最少会有 k 个结点。(k ≥ 1) ** [证明用求等比数列前 k 项和的公式]**
- 20 + 21 + … + 2k-1 = 2k-1
- 对任何一棵二叉树,如果其叶结点有 n 个,度为 2 的非叶结点有 n 个,则有 n0_PLACEHOLDER}=n0R}_PLACEHOLDER}00R}0EHOLDER}_PLACEHOLDER}0R}=nEHOLDER}_PLACEHOLDER}_PLACEHOLDER}00R}0EHOLDER}_PLACEHOLDER}0EHOLDER}_PLACEHOLDER}0R}0_PLACEHOLDER}**EHOLDER}_PLACEHOLDER}0EHOLDER}_PLACEHOLDER}=n_PLACEHOLDER}**+1 **
- _PLACEHOLDER}00_PLACEHOLDER}0:若设度为 1 的结点有 n 个,总结点个数为 n,总边数为 e,则根据二叉树的定义,n = n + n + n e = 2n + n = n - 1 因此,有 2n2 + n1 = n0 + n1 + n2 - 1 n2 = n0 - 1 n0 = n2 + 1
- 具有 n (n >= 0) 个结点的完全二叉树的高度为 [log(n+1)]
- 满二叉树可以用顺序结构实现
 补充:
n 个结点的完全二叉树的最大树枝节点:(n-1)/2
- 满二叉树是完全二叉树的特殊形态, 即如果一棵二叉树是满二叉树, 则它必定是完全二叉树。
实现
顺序实现
链式实现
二叉链表中结点的定义如下:
  class BinaryTreeNode {
   DataType data;
   BinaryTreeNode *leftChild, *rightChild; //左右指针
  public :
   BinaryTreeNode(DataType &e, BinaryTreeNode
                     *l=NULL, BinaryTreeNode *r=NULL)
  { data = e; leftChild = l; rightChild = r; }
   friend class BinaryTree; //声明友元类
  }; //BinaryTreeNode
  class BinaryTree {
   BinaryTreeNode *root;               //根结点指针
  public :
   BinaryTree( ) { root = NULL; }  //创建一个空的二叉树
   //如果二叉树为空,则返回true,否则返回false
   bool IsEmpty( );
    //置x为根结点值;若操作失败,则返回false,否则返回true
    bool Root(DataType &x);
   //创建二叉树
  void CreateBinaryTree(BinaryTreeNode *&t=root);
  void PreOrder(BinaryTreeNode *&t=root);
  void InOrder(BinaryTreeNode *&t=root);
  void PostOrder(BinaryTreeNode *&t=root);
  void LevelOrder( ); //逐层遍历
  //删除一棵二叉树,释放其结点。
  void Delete(BinaryTreeNode *&t=root);
  //返回二叉树的结点个数。
  int Size(BinaryTreeNode *&t=root);
  //返回二叉树的高度。
  int Height(BinaryTreeNode *&t=root);
  }; //BinaryTree
  二叉链表中基本操作的实现:
  bool BinaryTree:IsEmpty( ) {
  //如果二叉树为空,则返回true,否则返回false
  return (root ? true : false);
  }
  bool BinaryTree:Root(DataType &x) {
  //置x为根结点值,如果没有根结点,则返回false
  if (root) { root->data= x; return true;}
  return false; // 没有根结点
  }
  二叉链表中基本操作的实现:
  void BinaryTree:PreOrder(BinaryTreeNode * &t=root)
  { //前序遍历二叉树(递归算法)
   if (t)
  {
       cout<<t->data; //访问结点内容
       PreOrder(t->leftChild);
       PreOrder(t->rightChild);
  }
  }
  二叉链表中基本操作的实现:
  void BinaryTree:InOrder(BinaryTreeNode * &t=root)
  { //中序遍历二叉树(递归算法)
   if (t)
  {
       InOrder(t->leftChild);
       cout<<t->data; //访问结点内容
       InOrder(t->rightChild);
  }
  }
  二叉链表中基本操作的实现:
  void BinaryTree:PostOrder(BinaryTreeNode * &t=root)
  { //后序遍历二叉树(递归算法)
   if (t)
  {
       PostOrder(t->leftChild);
       PostOrder(t->rightChild);
       cout<<t->data; //访问结点内容
  }
  }
线索二叉树
非线性结构 (树形结构) → 线性结构 (前驱, 后继)
二叉树结点之间的前驱和后继关系只有在某种次序(前序、中序、后序)的遍历过程中才能确定。
- 如果能事先知道二叉树结点之间在某种遍历次序(前序、中序、后序)下的前驱和后继关系,那么根据这些前驱和后继即可获得该次序(前序、中序、后序)下的遍历结果。
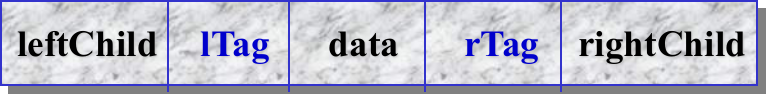
- **Pre 和 Succ,分别指向该结点在某种次序下遍历时的前驱和后继 (无孩子, 指针域为空)。 **
- lTag=0,leftChild 指向左子女
- lTag=1,leftChild 指向前驱
- rTag=0,rightChild 指向右子女
- rTag=1,rightChild 指向后继
- 缺点:浪费存储空间。0EHOLDER}_PLACEHOLDER}0。
三序线索二叉树
0EHOLDER}_PLACEHOLDER}0_PLACEHOLDER}0_PLACEHOLDER}**
  class ThrBNode{
    DataType data;
    ThrBNode *leftChild, *rightChild;
    bool  lTag, rTag;
  public:
    ThrBNode(DataType d){
        data=d;
        leftChild= rightChild=NULL;
        lTag=rTag=false;
    }
    friend class InThrBTree;
  }; //ThrBNode
  class InThrBTree {   //线索二叉树类
     ThrBNode *thrt;   //头指针,指向根结点
     ThrBNode *GetFirstNode(ThrBNode *);
     ThrBNode *GetNextNode(ThrBNode *);
  public:
     //创建一个带表头,但不带线索的空二叉树
     InThrBTree() { thrt=new ThrBNode(); }
     //创建一个带表头,但不带线索的二叉树
     void CreateBTree(ThrBNode *&t=thrt);
    //创建一个带表头,但不带线索的二叉树,其中:
       //data为根结点值,left和right是左右子树
    void MakeTree(DataType &data,
             InThrBTree &left, InThrBTree &right);
    //中序线索化
    void InOrderThreading(ThrBNode *&bt);
    void InOrder( );
  }; //InThrBTree
  void InOrderThreading(ThrBNode *p, ThrBNode *pre=NULL) {
     if (p == NULL) return;
     InOrderThreading(p->leftChild, pre);
     if (p->leftChild == NULL) {   //对p的左指针进行处理
         p->lTag = 1;
         p->leftChild = pre; } //设置p的前驱线索
     if (p->rightChild == NULL)
         p->rTag = 1; //对p的右标志进行处理
     if (pre->rTag == 1)
         pre->rightChild = p;  //设置pre的后继线索
     pre = p;
     InOrderThreading(p->rightChild, pre);
  }
  ThrBNode* InThrBTree:GetFirstNode(ThrBNode *p) {
    //求中序序列中的第一个结点
   while (!p->lTag)   p=p->leftChild;
     //沿左链走直到无左子女的结点
   return p;
  }
  ThrBNode* InThrBTree:GetNextNode(ThrBNode *p ) {  //求p在中序序列中的后继
    if (p->rTag)  return p->rightChild;  //P无右子女
    r=p->rightChild;  //r指向p的右子树的根
    r=GetFirstNode(r);  //求右子树中序的第一个结点
    return r;
  }
  void InThrBTree:InOrder( ){
     p=thrt;    //取根结点
     if(p==NULL)
         return;
     p=GetFirstNode(p);
     cout<<p->data;
     while(p->rightChild!=NULL) {
         p=GetNextNode(p);
         cout<<p->data;
     }
  } //InOrder
遍历的非递归实现
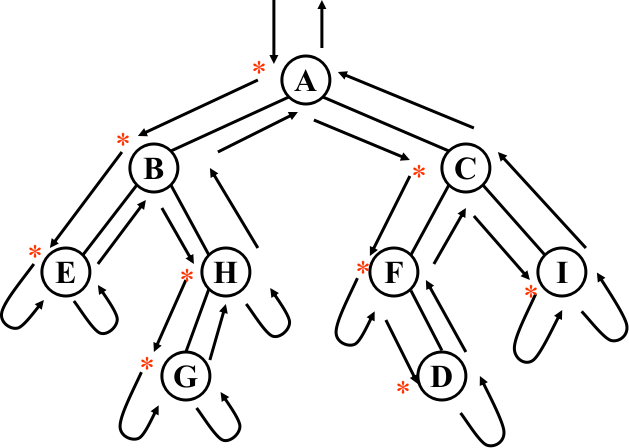
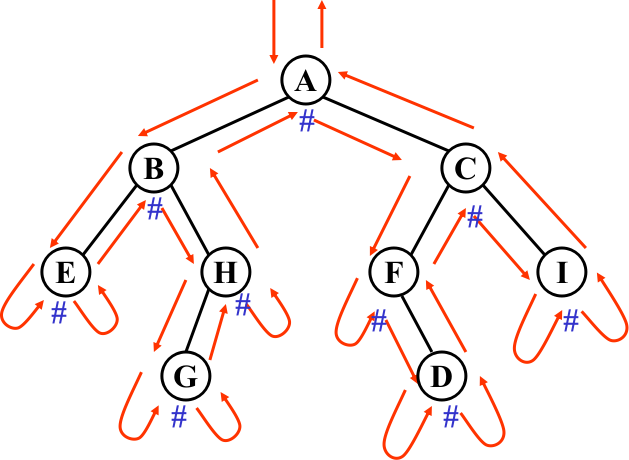
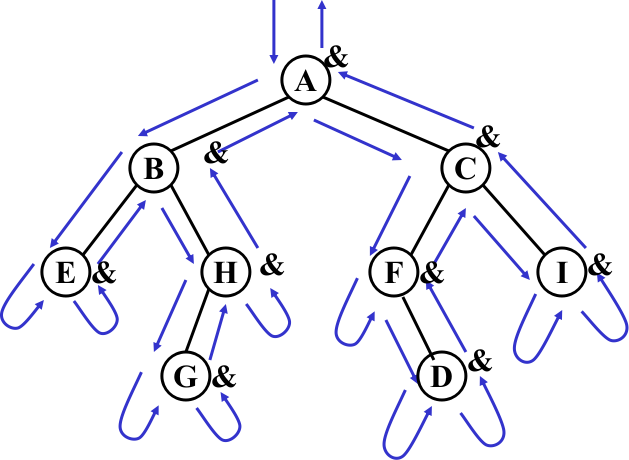
递归算法在执行的过程中会使用到栈结构——隐式栈。
递归算法转成非递归算法时,也需要使用到栈结构——显式栈。
- 栈结构需要手动开辟。
- 二叉树遍历的非递归实现需要手动开辟栈结构,完成遍历过程。
    void PreOrder(BinaryTreeNode *&p=root) {
        Stack  stack; //建立栈
        while (p || !stack.IsEmpty( )) {
         if(p) {
             cout<<p->data;
             stack.Push(p);
             p=p->leftChild;
         } //向左走
         else {
             p=stack.Pop( );
             p=p->rightChild; } //向右走
       } //while
    } //PreOrder
    void InOrder(BinaryTreeNode *&p=root) {
        Stack  stack; //建立栈
        while (p || !stack.IsEmpty()){
         if (p) {
             stack.Push(p);
             p=p->leftChild;
         }   //向左走
         else {
             p=stack.Pop();
             cout<<p->data;
             p=p->rightChild;
         }      //向右走
        } //while
    } //InOrder
    void BinaryTree:PostOrder(BinaryTreeNode *&p=root)){//后序遍历
        Stack stack;             //建立栈
        while (p || !stack.IsEmpty()){
         if (p) {
             stack.Push((p, 'L')); //(p, L)入栈
             p=p->leftChild;    //p向左走
         }
       else {
           e=stack.Pop(); //弹出栈顶元素到e中
           p=e.p;
           tag=e.tag;
           if (tag=='R') {
               cout<<p->data;
               p=NULL;
           }
           else {
               stack.Push((p, 'R'));
               p=p->rightChild;   //p向右走
           }
           } //end else
       } //end while
    } //PostOrder
层次遍历算法 LevelOrder 的非递归实现
  void BinaryTree:LevelOrder( ) {
  //层次遍历二叉树的非递归算法
  LinkedQueue   q; //链式队列
  BinaryTreeNode  *p=root;
  q.Enter(p);
  while(!q.IsEmpty( )) {
     p=q.Leave( );
     cout<<p->data;
     if(p->leftChild)  q.Enter(p->leftChild);
     if(p->rightChild)  q.Enter(p->rightChild);
  } //end while
  } //LevelOrder
树和森林
存储
双亲表示法——顺序结构
- 0
- **不适用求结点子女等操作。 存在“上限”问题。 **
    class NodeType {
        DataType data;
        int parent;
    }; //NodeType
    class PTree {
        NodeType nodes[MAX_TREE_SIZE];
        int n; //已存储的结点个数
      public:  ……
    }; //PTree
子女表示法——顺序结构 + 链式结构
0_PLACEHOLDER}**
**不适合求结点双亲等操作。 存在“上限”问题。 **
  class CNode {  //孩子结点
    int child;
    CNode *next;
  }; //CNode
  class CList {  //孩子链表
    DataType data;
    CNode *firstChild;
  }; //CList
  class CTree {  //结点的指针数组
    CList nodes[MAX_TREE_SIZE];
    int n, r;  //结点个数及根的位置
  }; //CTree
子女兄弟表示法——链式结构
- **_PLACEHOLDER}**EHOLDER}_PLACEHOLDER}0
- =n_PLACEHOLDER}_PLACEHOLDER}00
- 0
- 0_PLACEHOLDER}**
    class CSNode {  //二叉链表的结点
        DataType data;
        CSNode *firstChild, *nextSibling;
      public:
        CSNode( ) { firstChild=nextSibling=NULL }
    }; //CSNode
先根次序遍历
当树非空时访问根结点;依次先根遍历根的各棵子树。
后根次序遍历
当树非空时依次后根遍历根的各棵子树;访问根结点。
没有中序是因为不是二叉树. 有多个子女, 根节点不知道从哪里输出
森林与二叉树的关系
链表的结构是完全一致
两种二叉链表中指针的含义不同:
- 0:左指针指向第一个子女,右指针指向下一个兄弟。
- 0:左指针指向左子女,右指针指向右子女。
0:凡是“兄弟”用线连起来,然后仅保留双亲到其第一个子女的连线,去掉双亲到其他子女的连线。
0EHOLDER}_PLACEHOLDER}0:若某结点是其双亲的左孩子,则该结点的右孩子、右孩子的右孩子 …,都与该结点的双亲连接起来,最后去掉所有双亲到右孩子的连线。
Huffman 树与编码
0_PLACEHOLDER}_PLACEHOLDER}:两个结点之间的路径长度是连接这两个结点的路径上的分支个数。
叶子结点的权值
二叉树的带权路径长度: 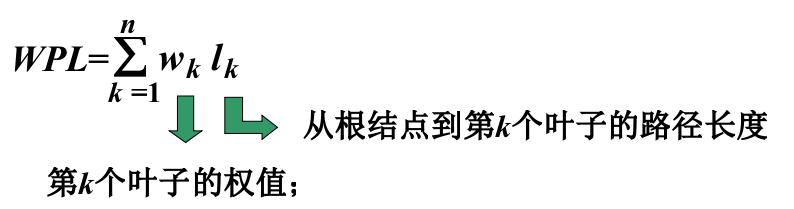
0:给定一组具有确定权值的叶子结点,使得带权路径长度达到最小的那棵二叉树。
- 权值越大的叶子结点越靠近根结点,而权值越小的叶子结点越远离根结点。
- 只有度为 0(叶子结点)和度为 2(分支结点)的结点,不存在度为 1 的结点。
- 一种 0_PLACEHOLDER}。解码时 不会出现混淆。 例如:设有 abcd 需要编码表示(其中,a=0、b=10、c=110、d=11,则0**)
n 个叶子结点构造出的 Huffman 树共有多少个结点?
- 因为 n=n+1,所以 n=n-1,又由于在 Huffman 树中没有度为 1 的结点,所以在 Huffman 树中结点总数为: n+n-1=2n-1
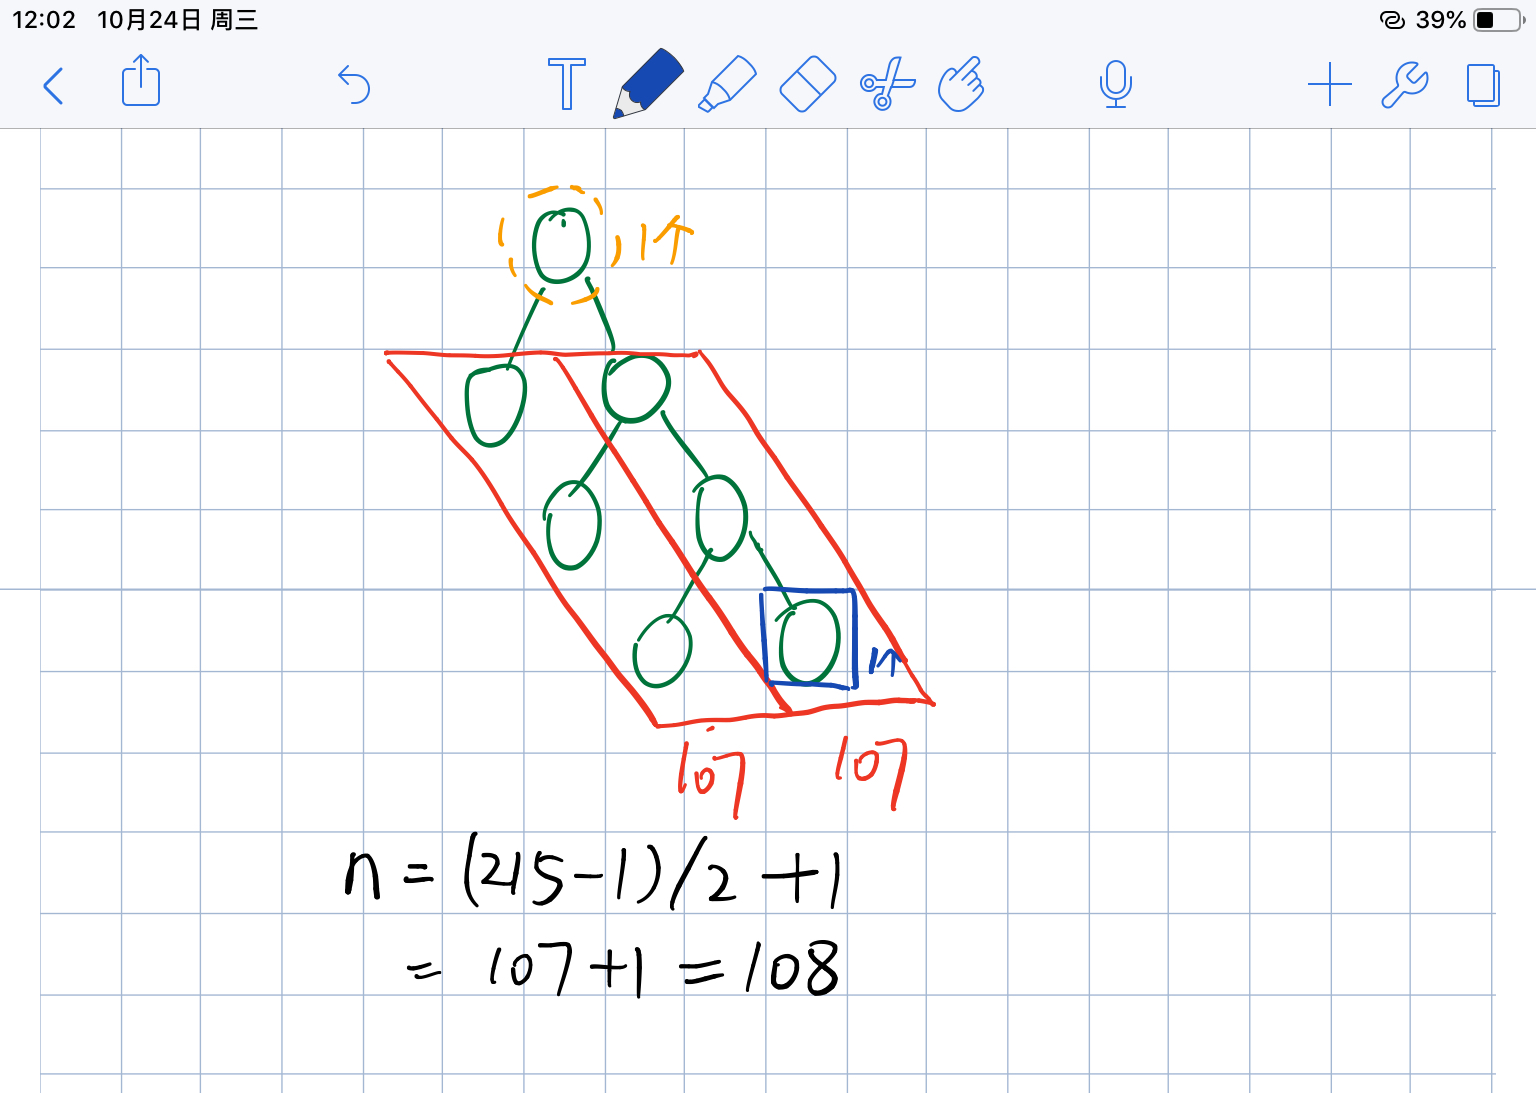
一棵哈夫曼树共有 215 个结点,对其进行哈夫曼编码,共能得到 () 个不同的码字
- 除了树根总共有 n-1 = 214 个 , 叶子节点为 214 的一半再加一个
求每个字符的哈夫曼编码算法
  void GetCode( ) {
  code=new String[n];
  for (k=0; k<n; k++) { //从叶子到根逆向求编码
    p=k;
    while ((q=tree[p].parent)!=-1) {
        if(tree[q]. leftChild ==p) code[k]+="0";
        else code[k]+="1";
        p=q;
    } //end while
    code[k].reverse(); //字符串反序
  } //end for
  } //GetCode
图
定义 & 基本术语
图是由 _PLACEHOLDER} 及 0_PLACEHOLDER}** 集合组成的一种**数据结构 **G=(V, E)
- V = { x | x ∈ 某个数据对象} 是0;
- E = {(x, y) | x, y∈V} 是边 (Edge) 的集合
- E = {<x, y> | x, y ∈ V && Path<x, y>} 是弧 (Arc) 的集合, Path<x, y>表示从顶点 x 到 y 的一条单向通路,它是有方向的。
权
带权图(或网)
顶点的度 (D(v)) : 与顶点 v 所关联的边数
自环
多重边(或弧)
_PLACEHOLDER} 不含自环和多重边(或弧)的图
0
=n:起点和终点相同回路:起点和终点相同的路径
- _PLACEHOLDER}00: 若一条路径上各顶点 V, V, …,V 均不相同
- **简单回路(简单圈): **起点和终点相同的简单路径,称为简单回路
0_PLACEHOLDER}**:沿路径边的数目或沿路径各边权值之和
0:已知图 G(V, E) 和图 G’(V’, E’),若满足:V’∈V 且 E’∈E,则称图 G’ 为图 G 的子图。
**连通图: **
- 0: 极大连通子图
- **强连通图: **
- 任意一对顶点 v 和 v,都存在一条从 v 到 v 和从 vj 到 vi 的 (有向) 路径。
- 0:有向图中的极大强连通子图称为该有向图的强连通分量。
生成森林:在非连通图中,每个连通分量可生成一棵树,所有连通分量生成的树可组成生成森林。
  class Graph {
   public:
     Graph ( );
    void InsertVertex( Type & vertex );
     void InsertEdge( int v1,  int v2,  int weight );
     void RemoveVertex( int v );
     void RemoveEdge( int v1,  int v2 );
     int GetFirstNeighbor( int v );
     int GetNextNeighbor( int v1,  int v2 );
    …… //其他成员函数
      };
邻接矩阵
邻接表
遍历
深度优先遍历 (Depth-First Search, DFS)
时间复杂度: 设有 n 个顶点,e 条边(或弧)的无(或有)向图。
- 如果用邻接矩阵存储图:(邻接矩阵与 e 无关) 在 DFSTraverse( ) 函数中,
- 初始化 visited 数组所需时间为 O(n),并调用 n 次 DFS( ) 函数;
- 在 DFS( ) 函数中,需要遍历邻接矩阵的一行才能得到邻接点,因此循环将执行 n 次;
- 综上,无向图深度优先遍历算法的时间复杂度为 O(n)+O(n*n)=O(n+n2),即:O(n2)。 有向图的深度优先遍历算法的时间复杂度也为 O(n2)。
- 如果用邻接表存储图:
- 在 DFSTraverse( ) 函数中,初始化 visited 数组所需时间为 O(n),并调用 n 次 DFS( ) 函数;
- 在 DFS( ) 函数中,每个顶点对应链表中边结点的个数为该顶点的度,因此循环将执行 D(V) 次。
- 综上,无向图深度优先遍历算法的时间复杂度为 O(n)+O(2e)=O(n+2e),即:O(n+2e)。 有向图的深度优先遍历算法的时间复杂度为 O(n+e)。(只有出度邻接表的情况)
    void  DFSTraverse( ) {  //深度优先遍历算法
        int  visited[n];       //开辟访问标志数组
       for (int v=0; v<n; v++)
       visited[v]=0;      //初始化访问标志数组
       for (v=0; v<n; v++)
           if (!visited[v])
               DFS(v);  //每次从尚未访问过的顶点中
                 //选取一个顶点v,从顶点v出发调用DFS(v)
    } //DFSTraverse
    void  DFS(int v) {
      //从顶点v出发访问包含该顶点v的最大连通子图中的所有顶点
        visited[v]=1;
        visit(v);      //或cout<<v;
        for(w=FirstAdjVex(v); w!=-1; w=NextAdjVex(v, w))
        if (!visited[w])
            DFS(w); //递归调用
    } //DFS
    //假定以邻接矩阵存储图:
    int  FirstAdjVex(int v) {
        int w=0;
        while(w<n && matrix[v]\[w]==0)
        w++;
        if(w<n)
         return w;
    else return -1;  //v没有邻接点
    }
    //假定以邻接矩阵存储图:
    int  NextAdjVex(int v, int w) {
        u=w+1;
        while(u<n && matrix[v]\[u]==0)
        u++;
        if(u<n)
         return u;
    else return -1;  //v没有邻接点
    }
    int FirstAdjVex(int v) {
        if(ghead[v]->firstout)
        return ghead[v]->firstout.adjvex;
        else
        return -1;
    }
    int NextAdjVex(int v, int w) {
        p=ghead[v]->firstout;
        while (p && p->adjvex!=w)
        p=p->link;
        if (!p || !p->link)   return -1;
        else   return p->link->adjvex;
    }
这里面的记忆数组在那里.
广度优先遍历 (Breadth-First Search, BFS)
  void  BFSTraverse( ){  //广度优先遍历算法
   int  visited[n];              //设置访问标志数组
  for (v=0; v<n; v++)
      visited[v]=0;             //初始化访问标志
  for (v=0; v<n; v++)
        if (!visited[v])
           BFS(v);
  } //BFSTraverse
  void BFS(int v) {
   Q=new Queue( ); //清空队列Q
   Q.Enter(v);         //将起始顶点v入队
   visited[v]=1;        //标记v
   while (!Q.IsEmpty()) {       //队列Q不空
        u=Q.Leave( );               //出队头元素到u
        visited(u);                    //访问u
        for (w=FirstAdjVex(u); w!=-1; w=NextAdjVex(u, w))
            if (!visited[w]) {
                Q.Enter(w);  //将u的每个未被访问的邻接点w入队
                visited[w]=1;
            }
    }
  } //BFS
无向图
n-1 ⇐ 网络 ⇐Cn2=n(n-1)/2
最小生成树
- 0存储连通无向网
- 最小生成树 不唯一! Kruskal(克鲁斯卡尔)算法
- 设一个含有 n 个顶点的连通无向网 N = { V, E },最初先构造一个只有 n 个顶点,没有边的非连通图 T = { V, (空集) },图中每个顶点自成一个连通分量。
- 当在 E 中选到一条具有最小权值的边时,若该边的两个顶点落在不同的连通分量上,则将此边加入到 T 中;否则,将此边舍去,重新选择一条权值最小的边。
- 按上述方式重复下去,直到所有顶点都在同一个连通分量上为止。
- **时间复杂度: **O(elog2e)
- 仅与边的数目有关,而与顶点的数目无关
- 适用求边稀疏的连通无向网的最小生成树
      //Prim(普里姆)算法
      #include <iostream>
      #include <cstring>
      using namespace std;
      const int MaxSize=201;
      const int IV=1000000;
      class AddArray { //辅助数组类
          int  adjvex;//对应下标所要组合的边
          int lowcost;//组合的代价
      public:
          AddArray():adjvex(0),lowcost(IV){}
          friend class MST;
      };
      class MST{
          int n;//需要处理的顶点
          int m;//边数
          int start;//开始的地方
          bool AdjMatrix[MaxSize]\[MaxSize];//邻接矩阵存图
          int Cost[MaxSize]\[MaxSize];//权值
          AddArray closedge[MaxSize];//辅助数组
          AddArray edge[MaxSize];//结果保存到数组edge中。
          int *U;//顶点标记数组, 下标表示边
      public:
          MST(int,int);
          void Setclosedge();
          int Minimum();// 求下个顶点
          void MST_Prim(int u);
          void Print();
          bool JudgeIegal();
      };
      MST:MST(int a,int b):n(a),m(b){
          U=new int [a+1];//下标从0开始,   实际多输入一组边
          memset(U,0, sizeof(U));
          memset(AdjMatrix,false,sizeof(AdjMatrix));
          for(int i=0;i<=a;i++){
      for(int j=0;j<=a;j++){
          Cost[i]\[j]=IV;
      }
          }//初始化 Cost, 忌用 memset
      };
      void MST:Setclosedge() {
          int temp1,temp2;
          int temp3;
          for(int i=m;i>0;i--) {
      cin >> temp1 >> temp2 >> temp3;
      AdjMatrix[temp1]\[temp2] = true;
      AdjMatrix[temp2]\[temp1] = true;
      Cost[temp1]\[temp2] = temp3;
      Cost[temp2]\[temp1] = temp3;
          }
      }
      int MST:Minimum() {
          int min=IV;
          int target=-1;
          for(int i=n;i>=0;--i){//遍历节点找到身边最小的节点
      //        cout<<min<<" "<<closedge[i].lowcost<<"\n";
      if( !(U[i]) && closedge[i].adjvex && closedge[i].lowcost < min){
          min=closedge[i].lowcost;
          target=i;
      }// 在没有选中的数组里挑一个最小的
          }
          return target;
      }
      void MST:MST_Prim(int u) {
          start=u;
          if(!u){
      return;
          }
          U[u]=1; //从顶点u开始
          for (int v=1; v<=n; v++) //初始化辅助数组closedge为第一个节点的距离和权值
      if (AdjMatrix[u]\[v] && u != v){
          closedge[v].adjvex=u;
          closedge[v].lowcost=Cost[u]\[v];
      }
          for (int t=1; t<=n; t++) {//选择其余的n-1个顶点
      int k=Minimum(); //求出下一个顶点k
      if(k==-1){
      //            cout<<"没有找到应该进行的下一个节点\n";
          return ;
      }
      //        else cout<<"找到最小的下标"<<k<<"\n";
      u=closedge[k].adjvex;
      edge[k].lowcost=Cost[k]\[u];//保存选中边的权值
      edge[k].adjvex=u;//保存选中边的顶点
      U[k]=1;
      for (int j=1; j<=n; j++) //更新新点k以及k的关系权值
          if (Cost[k]\[j] < closedge[j].lowcost){
              closedge[j].lowcost=Cost[k]\[j];
              closedge[j].adjvex=k;
          }
          }
      }
      void MST:Print() {
          if(!JudgeIegal()) {
      cout<<"最小生成树长度为-1, 连通分支大于1";
      return;
          }
          cout<<"边的关系为:\n";
          for (int l = 1; l <= n; ++l) {
      if(l==start) continue;
      cout<<l<<" & "<<edge[l].adjvex<<" : "<<edge[l].lowcost<<"\n";
          }
          int step=0;
          cout<<"最小生成树长度为:\n";
          for (int l = 2; l <= n; ++l) {
      step+=edge[l].lowcost;
          }
          cout<<step<<endl;
      }
      bool MST:JudgeIegal(){
          for(int i=1; i<=n; ++i){
      if(!U[i]) return false;
          }
          return true;
      }
      int main(){
          int n,m;
          cout<<"输入节点的个数\n";
          cin>>n;
          cout<<"输入边的数量\n";
          cin>>m;
          MST temp(n,m);
          temp.Setclosedge();//初始化
          temp.MST_Prim(1);
          temp.Print();
      }
      /*
      6
      输入边的数量
      10
      1 2 6
      2 3 5
      1 3 1
      3 4 5
      2 5 3
      5 3 6
      1 4 5
      4 6 2
      6 5 6
      3 6 4
       *
       * */
      //Kruskal(克鲁斯卡尔)算法
      #include<iostream>
      #include<algorithm>
      #include<fstream>
      using namespace std;
      int n, m;
      class Road {
          int x, y, l;
      public:
          friend class Tree;
      };
      class Tree {
          Road road[1000];
          int root[1000];
      public:
          void in(int x, int y, int l,int i);
          int getRoot(int x);
          int Kruskal();
      };
      void Tree:in(int x, int y, int l,int i) {
          road[i].x = x;
          road[i].y = y;
          road[i].l = l;
      }
      int Tree:getRoot(int x) {
          if (root[x] != x) root[x] = getRoot(root[x]);
          return root[x];
      }
      int Tree:Kruskal() {
          for (int i = 1; i <= n; i++) root[i] = i;
          sort(road, road + m, [](const Road& x, const Road& y)->bool {return x.l < y.l; });
          int ans = 0;
          int j=0;
          cout << "路径为:" << endl;
          for (int i = 0; i < m; i++) {
              int x = road[i].x;
              int y = road[i].y;
              if (getRoot(x) != getRoot(y)) {
                  ans += road[i].l;
                  j++;
                  cout << x << ' ' << y << ' ' << road[i].l << endl;
                  root[root[x]] = root[y];//合并并查集
              }
          }
          if (j < (n - 1)) {
              cout << "-1 无法构成最小生成树";
          }
          else
          cout << "最短路径长度为:" <<ans << endl;
          return ans;
      }
      int main() {
          cin >> n >> m;
          if(m < (n - 1)) cout << -1<<endl;
          Tree A;
          for (int i = 0; i < m; i++) {
              int x1, y1, l1;
              cin >> x1 >> y1 >> l1;
              A.in(x1,y1,l1,i);
          }
          A.Kruskal();
      }
最短路径
Dijkstra(迪杰斯特拉)算法
单源最短路径:某个顶点到其他顶点间的最短路径。
算法描述: 以邻接矩阵存储图,依次执行以下步骤:
- 0 设源点为 v0,则 find[0]=1; 其他 find[1..n-1]=0;
- dist[i] ← cost[0][i], i= 1, 2, …, n-1;
- 求出长度最短的路径 dist[k] ← min{ dist[i] }, i V- S; find[k]=1;
- 修改 dist 数组 对于每一个 i V- S,即:find[i]==0,更新其 dist[i] ← min{ dist[i], distk + cost[k][i] };若 S = V,则算法结束;否则,转 (2)。
const int Vexnum=20;//图中最大顶点个数
const int max=9999; //9999表示无穷大
class Graph { //图的类定义
float cost[Vexnum]\[Vexnum]; //邻接矩阵
float dist[Vexnum]; //最短路径长度数组
int path[Vexnum]; //最短路径顶点序列数组
int find[Vexnum]; //最短路径顶点集
public:
void ShortestPath_DIJ(int, float*);
int mininum(int);
}; //Graph
void Graph:ShortestPath_DIJ(int v0, float *dist) {//求从源点v0到其它顶点的最短路经。
for(v=0; v<Vexnum; v++){ //初始化
find[v]=0;
path[v]=0;
dist[v]=cost[v0]\[v];
}
find[v0]=1;
for(i=1; i<Vexnum; i++){
k=mininum(dist); //求出当前路径中的最小值
find[k]=1;
for(w=1; w<Vexnum; w++)
if(!find[w] && cost[k]\[w]<max)
if(dist[k]+cost[k]\[w]<dist[w]){//更新dist数组元素, V0VkVw替代V0Vw
dist[w]=dist[k]+cost[k]\[w];
path[w]=k;
}
}
} //ShortestPath_DIJ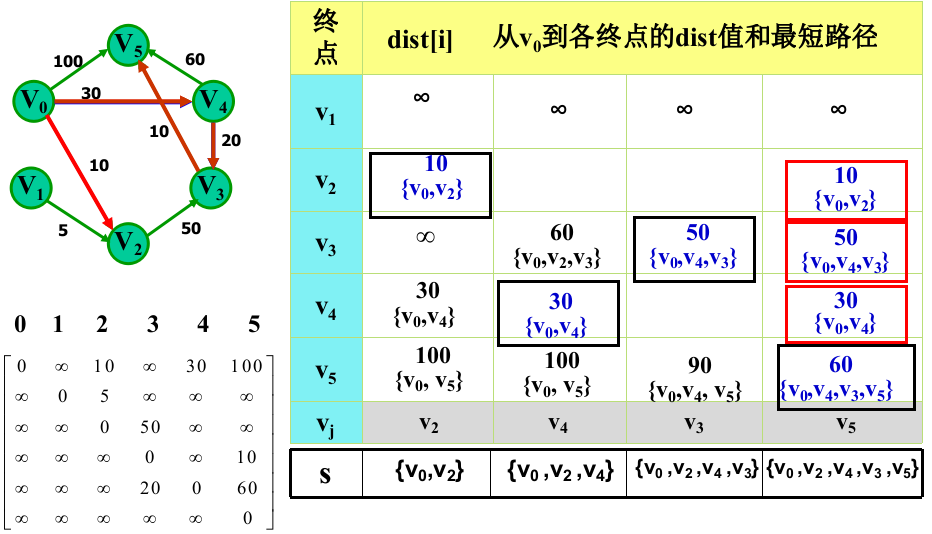
Floyd(弗洛伊德)算法
  #mark:   MAX_VERVEX_NUM  20
  #mark:   max  9999
  VextexType  PathMatrix[MAX_VERVEX_NUM, MAX_VERVEX_NUM];
  VRType  DistMatrix[MAX_VERVEX_NUM, MAX_VERVEX_NUM];
  void ShortestPath_Floyd(PathMatrix &path, DistMatrix &A) {//用邻接矩阵存储图
  for(v=0; v<n; v++)
      for(w=0; w<n; w++){ //初始化path
          A[v]\[w]= DistMatrix[v]\[w];
          if (A[v]\[w]<max) path[v]\[w]=v;
              else  path[v]\[w]=-1;
      }
  for(u=0; u<n; u++)
      for(v=0; v<n; v++)
          for(w=0; w<n; w++)
              if(A[v]\[u]+A[u]\[w]<A[v]\[w]){ //更新最短路径及其长度
                  A[v]\[w]=A[v]\[u]+A[u]\[w];
                  path[v]\[w]=path[u]\[w];
              }
  } //ShortestPath_Floyd
有向图应用
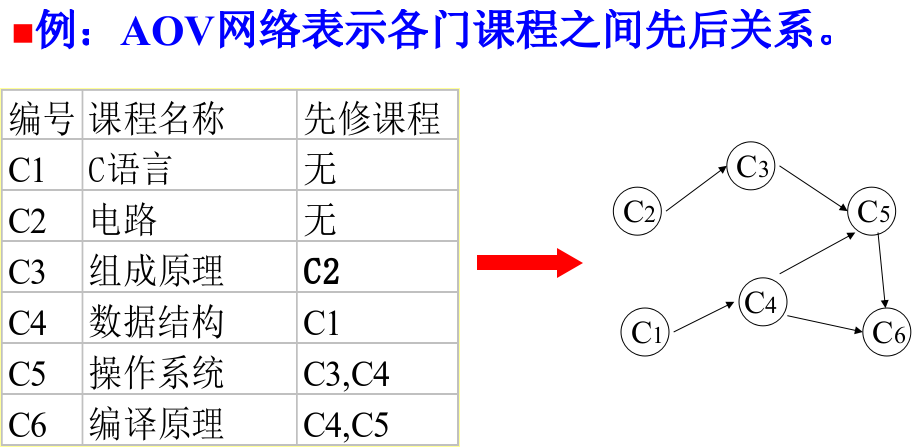
拓扑排序 :
在 AOV 网络中,寻找一个拓扑有序序列的过程。
- 活动网络(Activity Network) : 在一个表示工程的有向图中:
- 顶点:表示活动;
- 弧:表示0;例如:0。
- 这种有向图被称为顶点表示活动的网络 (Activity On Vertices, AOV),简称 AOV 网络。
- 例如:计算机专业学生攻读学位的过程就是一个工程。
- 每一门课程的学习是整个工程中的一个活动。
- 有些课程要求有先修课程,有些则不要求。
- 这样,课程之间可能存在先后关系。
- 拓扑有序序列:在 AOV 网络中,若将各个顶点 (代表各个活动)排列成一个线性有序的序列 v1, v2, …, vn,使得若从顶点 vi 到 vj 有一条有向路径,则在序列中顶点 vi 必须排在顶点 vj 之前。
- 在 AOV 网络中不能出现有向回路。
- 如果出现了有向回路,则意味着某项活动将以自己作为先决条件或者活动之间互为条件。
- 如果 AOV 网络中存在有向回路,则此 AOV 网络所代表的工程是不可行的。
- 因此,对给定的 AOV 网络,必须先判断它是否存在有向回路。
- 关键路径
- 例:
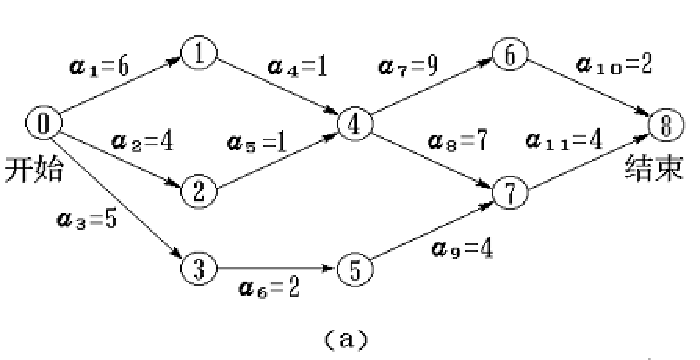
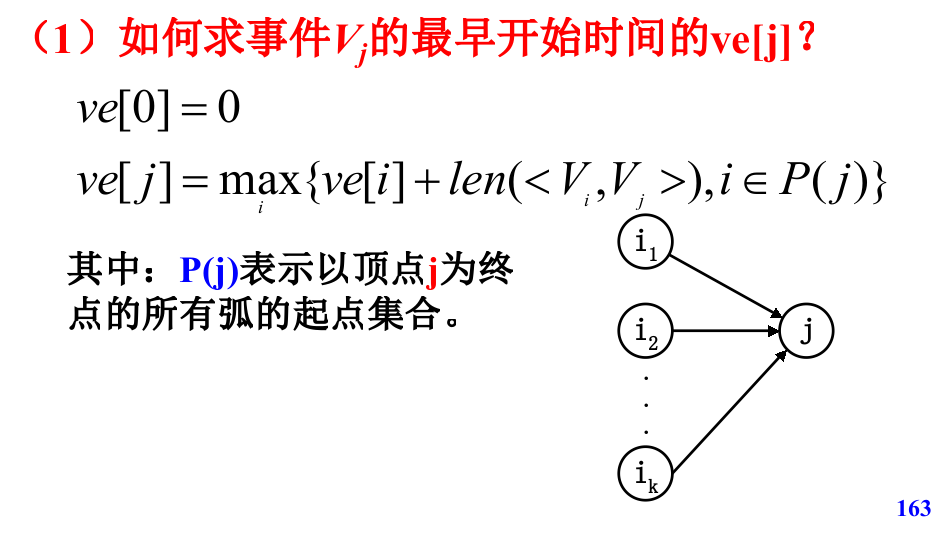
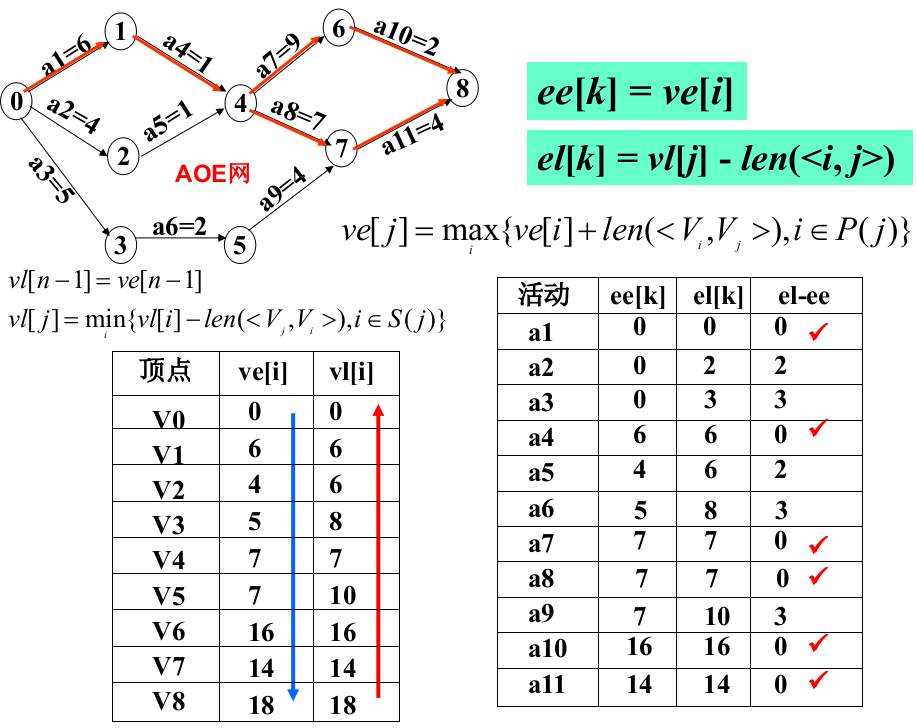
- 事件 Vi 的最早开始时间 ve[i]:从起点 V0 到顶点 Vi 的最长路径长度。
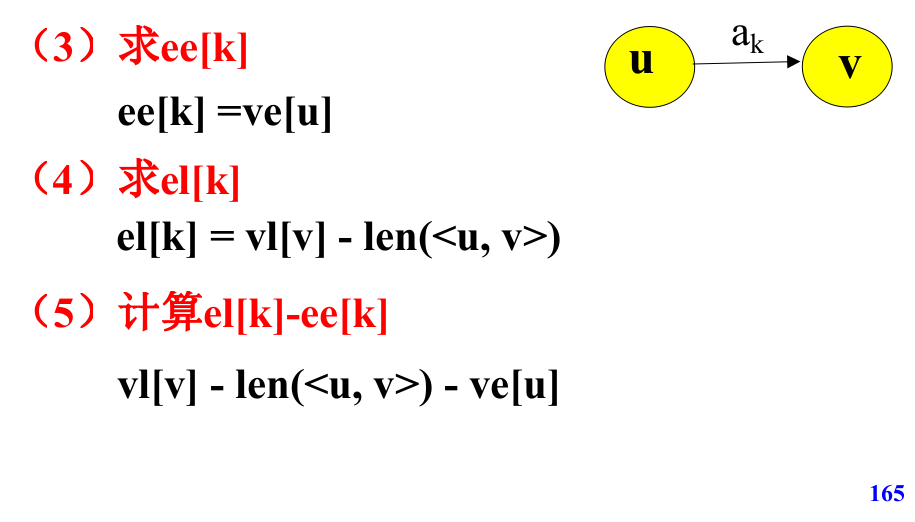
- 活动 ak 的最早开始时间 ee[k]:设活动 ak 在弧<Vi, Vj>上,则 ee[k] 是0。
- ee[k] = ve[i],它等于活动 ak 所在弧的起点事件 Vi 的最早开始时间。
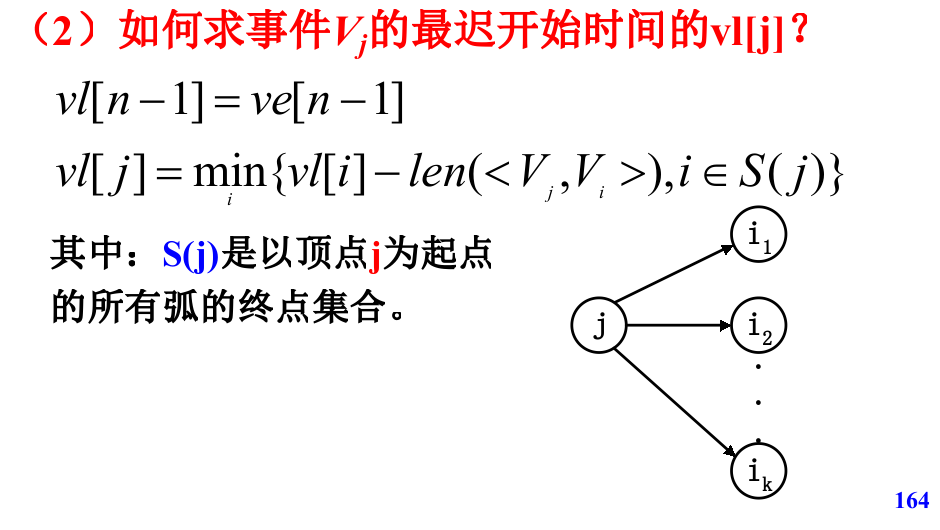
- 活动 ak 的最迟开始时间 0
- 活动 ak 的时间余量 el[k]-ee[k]:表示活动 ak 的最迟开始时间和最早开始时间之间的时间差。
- 当 el[k] == ee[k] 时,表示活动 ak 没有时间余量,即:ak 是关键活动。
- 为了找出 AOE 网络中的关键活动,需要计算出各活动的 ee[k] 与 el[k],以判别是否满足 el[k] == ee[k]。
- 为求得 ee[k] 与 el[k],需要先计算出各顶点 Vi 的 ve[i] 和 vl[i]。
查找技术
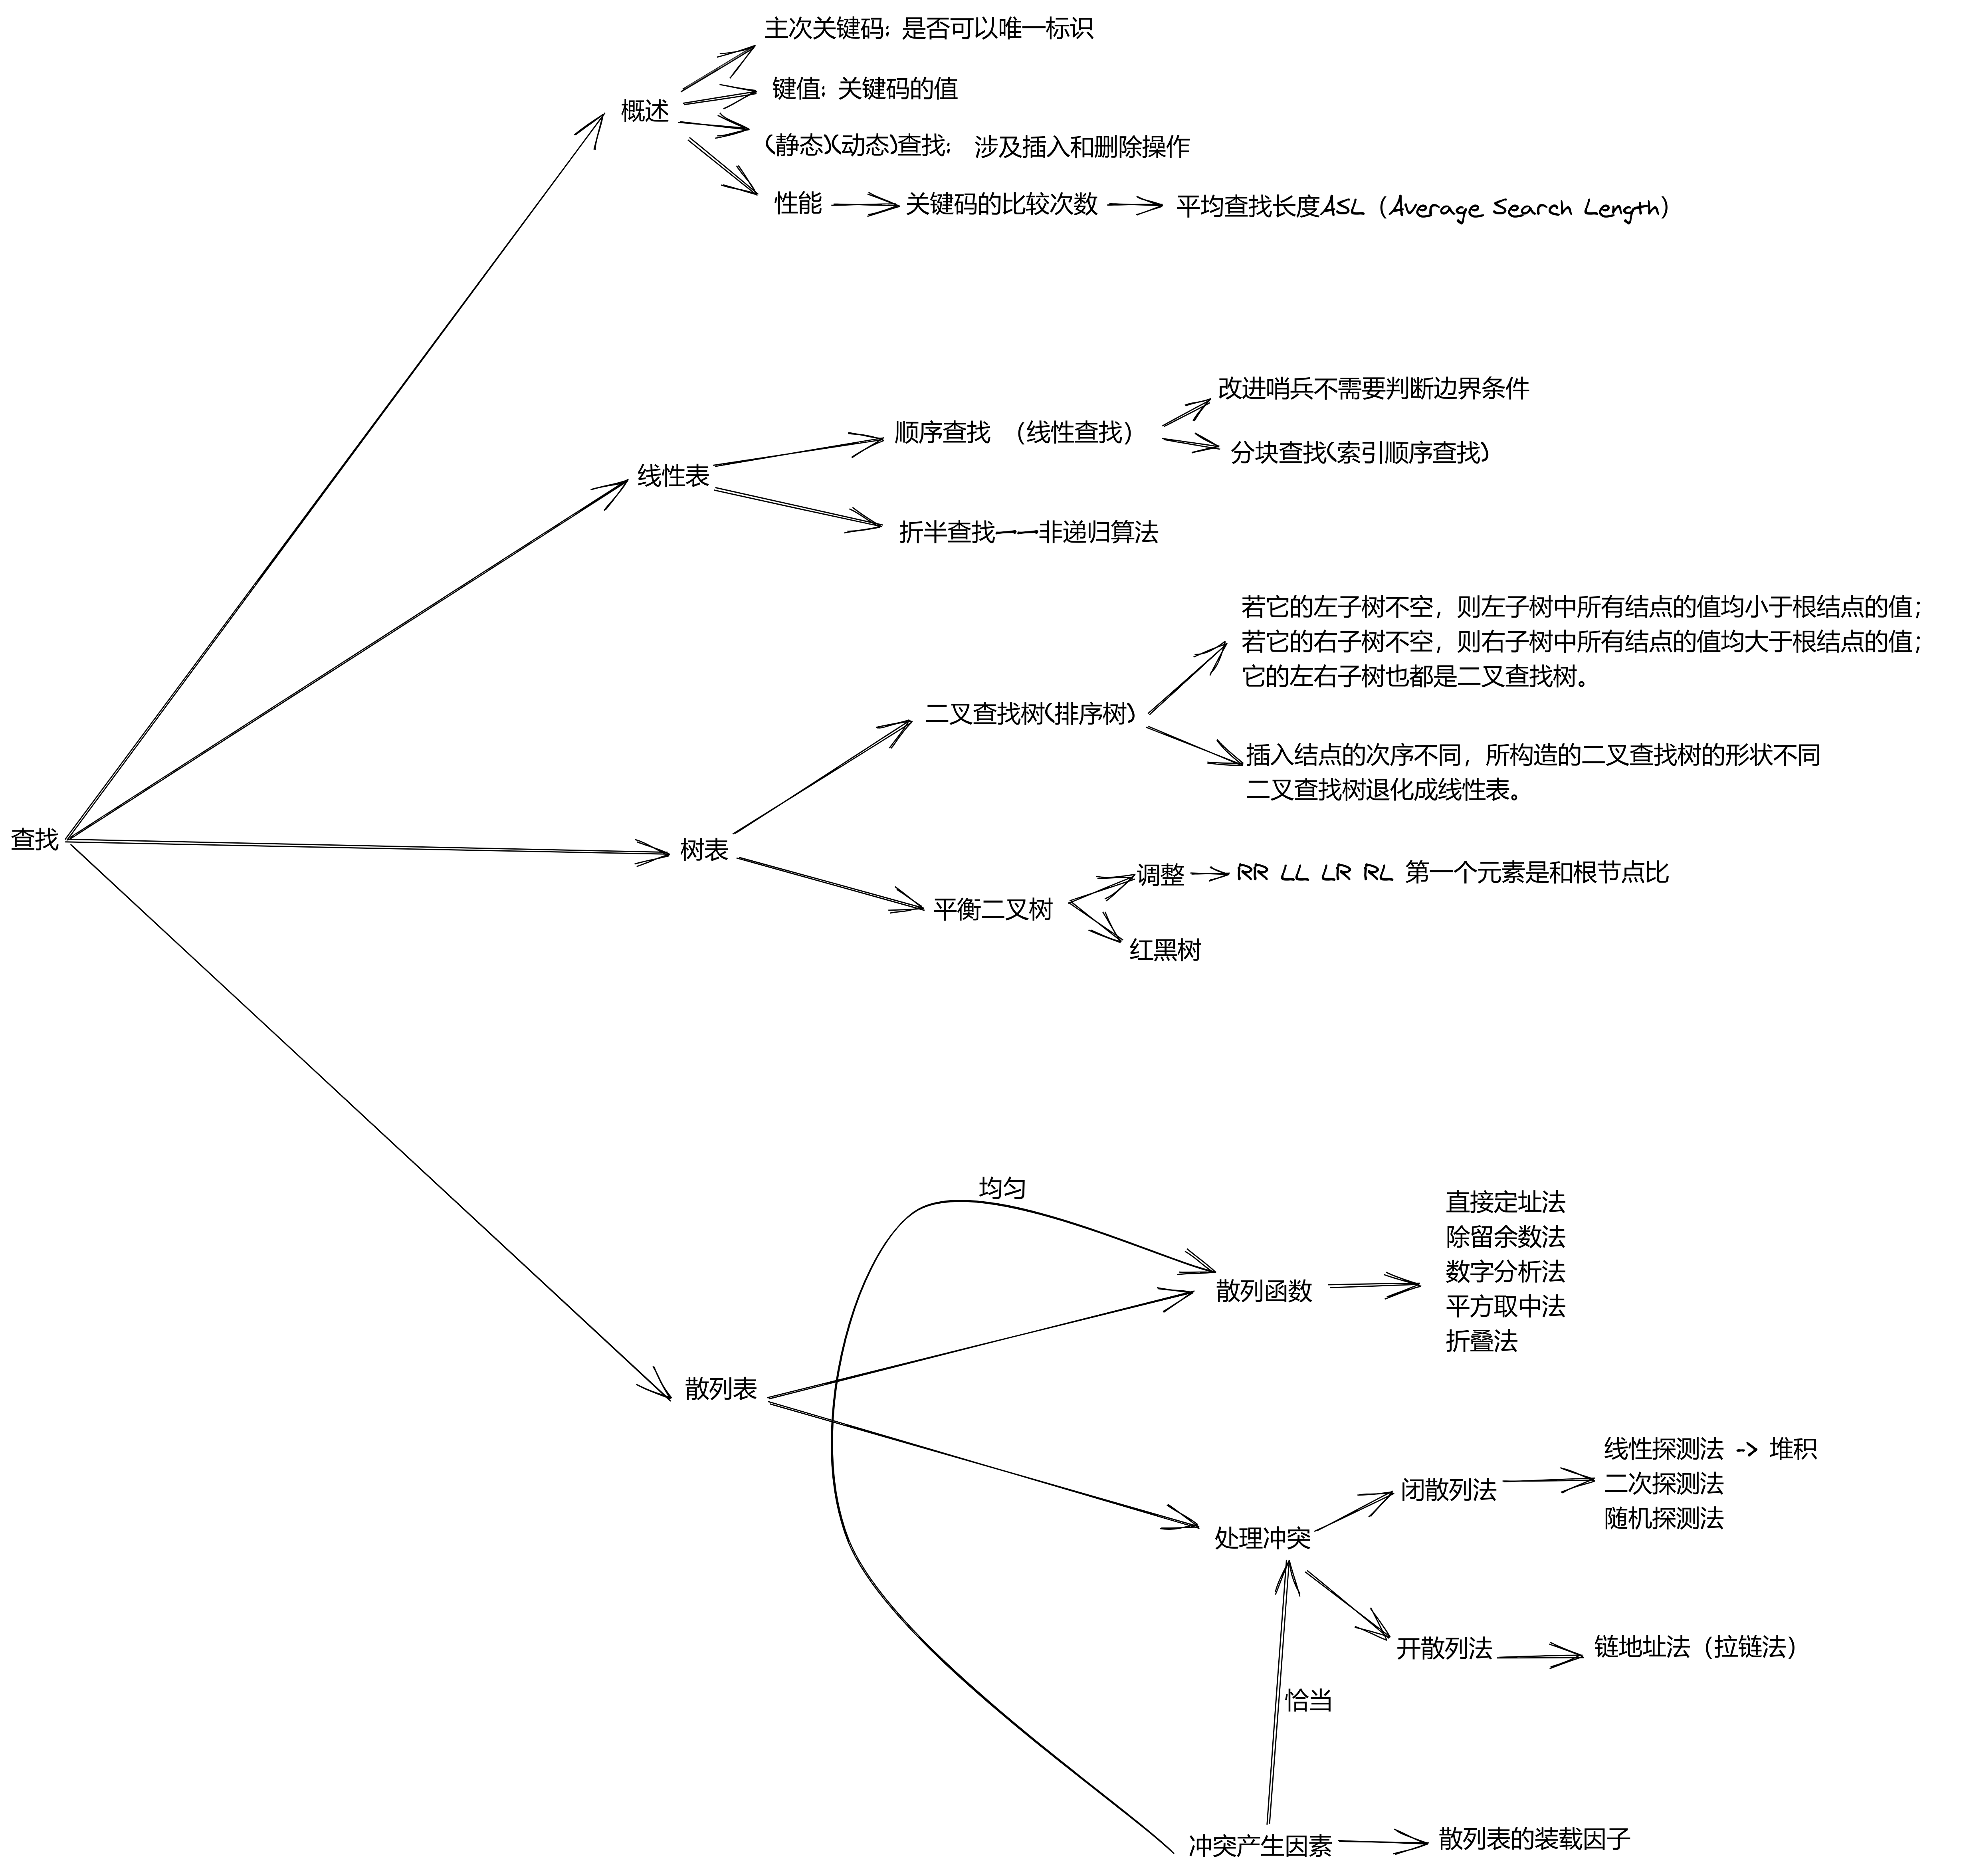
平均查找长度:查找算法中关键码比较次数的数学期望值,即:
- n:问题规模,查找集合中的数据元素个数;
- pi:查找第 i 个数据元素的概率;
- ci:查找第 i 个数据元素所需的关键码的比较次数
- 更多关于折半查找的例子: https://www.cnblogs.com/ygsworld/p/10238729.html
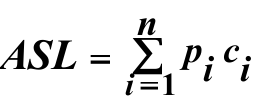
线性表
顺序查找 (线性查找)
折半查找
分块查找
要求将查找表分成 若干个子表,并对子表建立索引表,查找表的每一个子表由索引表中的索引项确定。
索引项包括两个字段:关键码字段 (存放对应子表中的最大关键码值) ;指针字段 (存放指向对 应子表的指针)
索引项按关键码字段有序
- 查找时,先用给定值 key 在索引表中 检测索引项,以确定所要进行的查找在查找表中的查找分块 (由于索引项按关键码字段有序,可用顺序查找或折半查找)
- 然后,再对该分块进行顺序查找。
代码: https://blog.csdn.net/hbtj_1216/article/details/50267977
树表
二叉查找树
  class BiSortTree{
  public:
   BiSortTree(int a[ ], int n);
   ~ BiSortTree( );
   void InsertBST(BiNode<int> *root , BiNode<int> *s);
  //若二叉查找树为空树,则新插入的结点为新的根结点;
  //否则,新插入的结点必为一个新的叶子结点,其插入位置由查找过程得到
   void DeleteBST(BiNode<int> *p, BiNode<int> *f );
   BiNode<int> *SearchBST(BiNode<int> *root, int k);
  private:
    BiNode<int> *root;
  };
  void BiSortTree:InsertBST(BiNode<int> *root, BiNode<int> *s){
  if (root == NULL)  root = s;
  else
      if (s->data < root->data) InsertBST(root->leftChild, s); //递归
      else InsertBST(root->rightChild, s); //递归
  }
  BiSortTree:BiSortTree(int r[ ], int n){ //构造函数
  for (i = 0; i < n; i++){
     s = new BiNode<int>;
     s->data = r[i];
     s->leftChild = s->rightChild = NULL;
     InsertBST(root, s);
  }
  }
平衡二叉树